En esta sección continuaremos nuestra introducción a R utilizando datos "reales". Descarguen el archivo expr.txt que contiene valores de expresión para 10,000 genes comparados en dos condiciones (wt y ko) cada uno con tres réplicas. En esta práctica nos vamos a enfocar a avanzar en nuestro aprendizaje de R, por lo que haremos un análisis sumamente manual de los datos. La sección de microarreglos de esta página contiene prácticas de cómo analizar completamente datos de expresión usando paquetes de Bioconductor.
Se acuerdan de cómo importar una tabla a R?
expr = read.table("expr.txt")

head(expr)

dim(expr)
              ko1  ko2   ko3   wt1   wt2  wt3
1416660_at   9.33 9.35 10.65 10.96 10.69 9.16
1422075_at   2.86 2.92  3.78  4.56  4.58 2.81
1439154_at   7.08 7.01  8.21  8.86  8.68 7.17
1457741_at   2.75 2.78  3.90  4.60  4.24 2.70
1455205_a_at 7.59 7.70  9.00  9.35  9.16 7.57
1451253_at   5.24 5.46  6.82  7.49  7.40 5.71

[1] 10000     6
Lo que necesitamos saber de estos datos es que representan genes diferentes, medidos en tres individuos del genotipo "ko" y tres individuos del genotipo "wt". Suponemos que la gran mayoría de los genes no deben cambiar entre individuos ni entre genotipo. Sin embargo, debe haber ciertos genes que cambien entre los genotipos, probablemente algunos incrementen su nivel de expresión y otros disminuyan.
Cómo entonces empezar el análisis? Recuerden, es muy importante empezar a visualizar los datos antes de tratar de hacer alguna inferencia. Esta tabla es demasiado grande para estudiarla a simple vista, por lo que conviene graficarla de alguna manera. El boxplot es la herramienta ideal!
boxplot(expr, col=rainbow(6), main="boxplot, raw data")
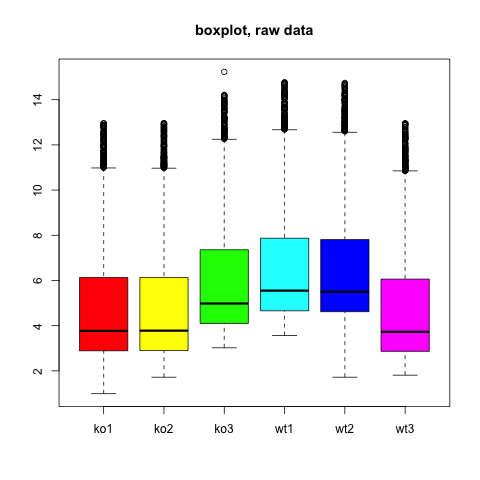
Creen que estos datos se ven bien? Cumplen con lo esperado que mencionamos arriba, en particular de que la mayoría de los genes no están cambiando?
Para los que no les queda totalmente claro el resultado del boxplot, y que están más familiarizados con los histogramas, cómo le harían para representar estos datos en forma de histogramas?
Podemos obtener un histograma de cualquier columna si la especificamos:
hist(expr[,1], breaks=50, main=1, col="skyblue", xlab="gene expression")
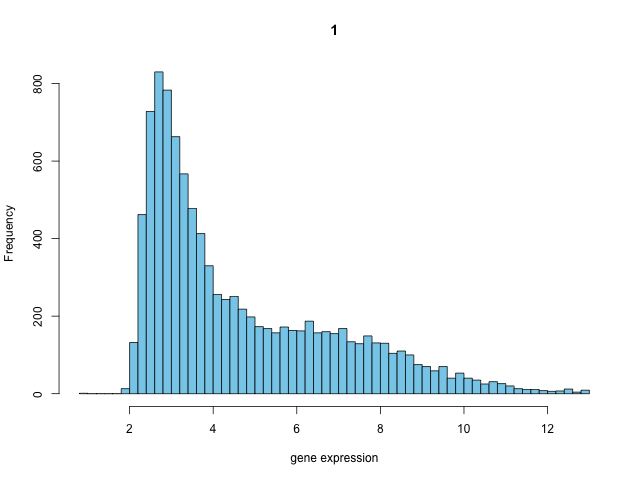
El histograma tiene un poco más de detalle, pero cómo le hacemos para producir fácilmente histogramas para todas las columnas?
Aprovechemos este punto para introducir la manera más sencilla de hacer ciclos en R, el comando for. Se usa de la siguiente manera:
for (i in 1:5) {
   print(i)
}
(el : en medio de dos números produce una secuencia de números, de uno en uno)
[1] 1
[1] 2
[1] 3
[1] 4
[1] 5
Cuántos histogramas queremos producir? A ojo podemos ver que son 6, pero podemos utilizar la función ncol para que nuestro código funcione para cualquier tabla de datos:
ncol(expr)
[1] 6
Entonces podemos utilizar un ciclo for para producir 6 histogramas.
for (i in 1:ncol(expr)) {
   hist(expr[,i], breaks=50, main=i, col="skyblue", xlab="gene expression")
}
Esto funciona, pero los histogramas se generan uno tras otro y no podemos verlos juntos. R nos deja tener control sobre el número de gráficas que produce por página, una opción es dividiendo la página en celdas tal que cada celda recibe una imágen. Para ello podemos especificar el número de renglones y columnas que definen las celdas:
par(mfrow=c(2,3))
La instrucción anterior modifica uno de los parámetros de graficado en R. Si queremos regresar al default de una imán por página, podemos cerrar la ventana con la imágen, o volver a especificar el parámetro pero con mfrow=c(1,1).
Ahora vuelvan a intentar el ciclo con los histogramas. Deben obtener algo así:
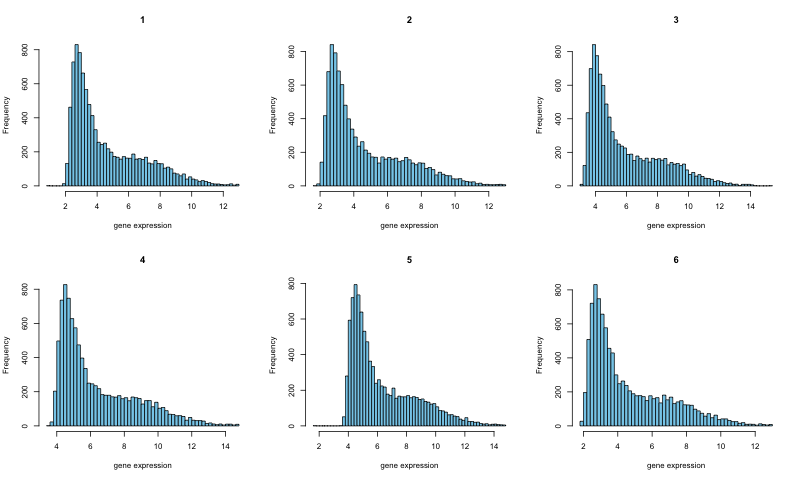
La ventaja de tener nuestro código en un ciclo for es que podemos modificar la instrucción del histograma una sola vez y se modificarán todos los histogramas que estamos generando. Podemos consultar la ayuda de hist y buscar cómo especificar el rango del eje de las X.
Aún después de todas estas manipulaciones, no creen que la figura del boxplot inicial es más sencilla de producir y permite el mismo tipo de interpretaciones?
De acuerdo a lo que hemos visto de la distribución de los datos, podemos imaginar que todas las muestras tienen la misma distribución pero que éstas se encuentran recorridas hacia mayor o menor expresión promedio.
Para corregir, o normalizar, estas diferencias, podemos hacer algo tan sencillo como centrar todas las distribuciones a un mismo valor. Cómo creen que podemos hacer esto en R?
Intentemos aprovechando que sabemos utilizar el ciclo for:
exprNorm = expr     # guardemos una copia para no sobreescribir los datos originales

for (i in 1:ncol(exprNorm)) {
   exprNorm[,i] = exprNorm[,i] - median(exprNorm[,i])
}
Cómo saber si funcionó? Fácil, una imágen!
par(mfrow=c(1,2))

boxplot(expr, col=rainbow(6), main="raw data")
boxplot(exprNorm, col=rainbow(6), main="normalized data")
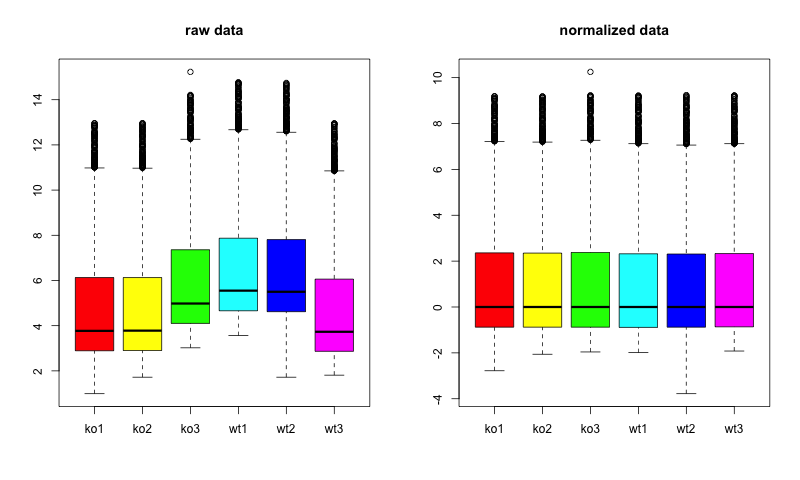
Ahora que estamos contentos con cómo se ven los datos, prosigamos a hacer un análisis comparativo. Este experimento es muy sencillo, ya que tiene solamente dos condiciones. Lo que queremos preguntarle a los datos es: qué genes se encuentran expresados diferentemente, en promedio, en los "ko" comparado con los "wt"?
Primeramente, debemos calcular el promedio de expresión entre las muestras "ko" como las muestras "wt", para cada uno de los genes. Con las herramientas que ya tenemos, probablemente tendríamos que utilizar un ciclo for para esto. Hagamos un pequeño ejemplo:
mini = as.matrix(head(exprNorm, 3))

mini

rownames(mini)    # rownames nos regresa los nombres de los renglones

for (i in rownames(mini)) {
   koMean = mean(mini[i,1:3])
   wtMean = mean(mini[i,4:6])

   print("#############")
   print(i)
   print(koMean)
   print(wtMean)
}
             ko1   ko2   ko3   wt1   wt2   wt3
1416660_at  5.56  5.57  5.67  5.41  5.19  5.43
1422075_at -0.91 -0.86 -1.20 -0.99 -0.92 -0.92
1439154_at  3.31  3.23  3.23  3.31  3.18  3.44

[1] "1416660_at" "1422075_at" "1439154_at"

1] "#############"
[1] "1416660_at"
[1] 5.6
[1] 5.343333
[1] "#############"
[1] "1422075_at"
[1] -0.99
[1] -0.9433333
[1] "#############"
[1] "1439154_at"
[1] 3.256667
[1] 3.31
A pesar de que puede ser "fácil" utilizar un ciclo for el resultado puede ser un poco complicado de acomodar, y es poco eficiente (porque va realizando las instrucciones ciclo por ciclo).
Para hacer estos procesos más eficientes, en R existe una serie de funciones de tipo apply que permiten "aplicar" una función sobre muchos datos a la vez. En este caso podemos usarlo así:apply(mini[,1:3], 1, mean) apply(mini[,4:6], 1, mean)
1416660_at 1422075_at 1439154_at
  5.600000  -0.990000   3.256667

1416660_at 1422075_at 1439154_at
 5.3433333 -0.9433333  3.3100000
Pueden consultar la ayuda de apply, pero básicamente recibe 3 argumentos: una tabla, la dimensión sobre la cual queremos aplicar una función (1 = renglones, 2 = columnas), y finalmente la función.
El histograma debe darles algo por el estilo:
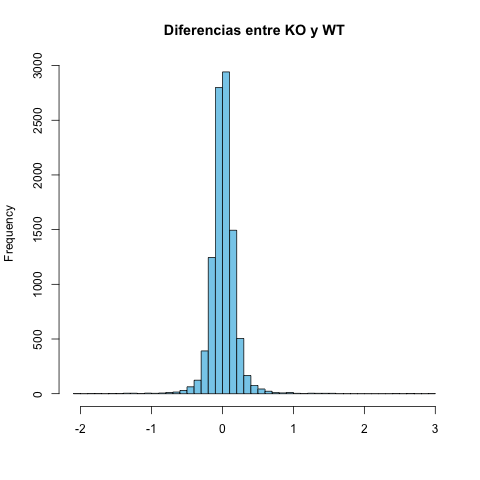
La solución al último ejercicio podría ser de la siguiente manera (si quieren trabajar con los datos antes de normalizar, cambien exprNorm por expr):
exprKo = exprNorm[,1:3]
exprWt = exprNorm[,4:6]

koMean = apply(exprKo, 1, mean)
wtMean = apply(exprWt, 1, mean)

diffMean = koMean - wtMean

hist(diffMean, breaks=50, col="skyblue", main="Diferencias entre KO y WT", xlab="")
Una pregunta muy importante ahora es que si este resultado, específicamente la magnitud del cambio entre los valores promedio de muestras "ko" y "wt", es verdaderamente lo que nos importa obtener.
Esto puede ser ilustrado mejor con dos ejemplos que están contenidos en los datos. En cada figura se muestra el valor de expresión de un gene y en las líneas horizontales el valor promedio para las "ko" y para las "wt". La flecha indica la magnitud de la diferencia que hemos calculado, y se muestra este número en el título.
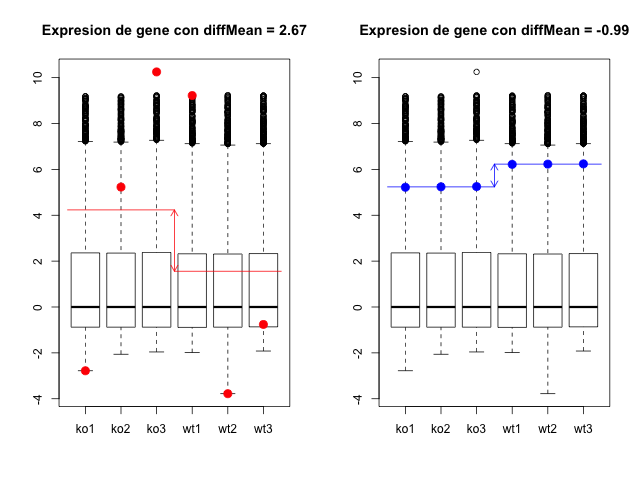
Claramente el primer gen tiene una magnitud de diferencia (a veces conocido como "fold-change") mayor al del segundo. Sin embargo, cuál resultado nos da mayor confianza y por qué?
Con este ejemplo se pretende ilustrar la "otra cara de la moneda" de cuando comparamos dos muestras de datos. No podemos enfocarnos solamente en la diferencia, si no tenemos que considerar la variabilidad de los datos. Es por esta razón que es muy mala idea hacer experimentos sin réplicas, pues nunca sabremos si una diferencia observada es reproducible o no. Recordemos que cuando estamos midiendo algo con tres individuos representativos de tipo "wt" y tres individuos de tipo "ko", queremos poder extrapolar nuestros resultados a todos los individuos de estos tipos en la población.
Podemos explorar el tema un poco más pensando en los siguientes ejemplos:
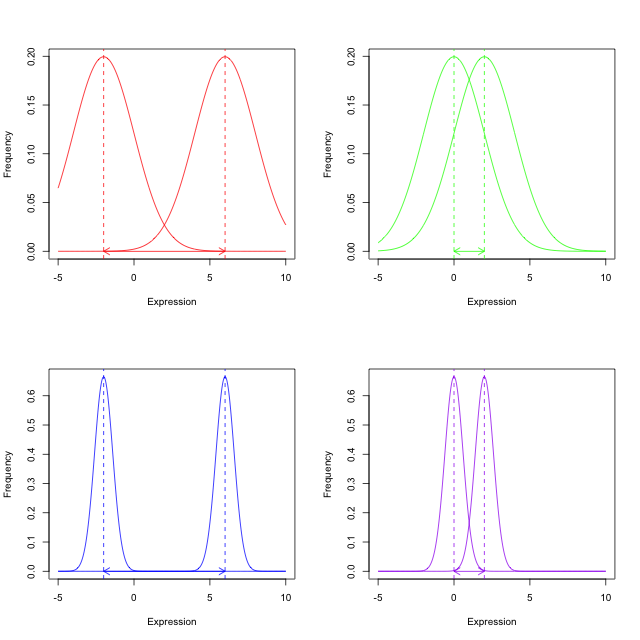
Con lo anterior, probablemente nos quede claro que debemos usar la estadística para decidir qué tan confiable es cada una de las diferencias de expresión que observamos. Es decir, queremos preguntar si las diferencias de expresión pudieron haber ocurrido al azar (hipótesis nula). Si encontramos que la probabilidad de que las diferencias pudieron haber ocurrido al azar es muy baja, rechazámos la hipótesis nula, aceptando la alternativa (que las diferencias son reales).
Muchos ya habrán oído sobre la prueba t de Student, o inclusive la han usado. Nos permite comparar dos muestras y decidir si sus medias son iguales o no. Esto es justamente lo que queremos hacer en el caso de la expresión de nuestros genes. Las condiciones para poder aplicar esta prueba son que las muestras deben tener una distribución normal. En general esta prueba se ha utilizado bastante para comparar datos de expresión provenientes de microarreglos, y se acepta que este tipo de datos cumplen con los requisitos de la prueba.
Veamos como usarla en R, aprovechando la mini matriz que preparamos anteriormente:
mini[1,1:3]
mini[1,4:6]

t.test(mini[1,1:3], mini[1,4:6])
 ko1  ko2  ko3
5.56 5.57 5.67

 wt1  wt2  wt3
5.41 5.19 5.43


   Welch Two Sample t-test

data:  mini[1, 1:3] and mini[1, 4:6]
t = 3.0366, df = 2.8, p-value = 0.06124
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -0.02354655  0.53687988
sample estimates:
mean of x mean of y
 5.600000  5.343333
Si quisieramos guardar solamente el p-value del resultado, hay una manera conveniente:
res = t.test(mini[1,1:3], mini[1,4:6])

res$p.value
[1] 0.06123795
Podemos ver que la prueba calcula un valor de probabilidad (p-value) de 0.06 para la hipótesis nula de que la verdadera diferencia en las medias SI es igual a 0. Entonces? Vamos a creer que el gen realmente está cambiando, o no?
Continuemos, ya que nos interesa evaluar todos y no solamente el primer gen. Podemos intentar primero con la mini matriz. Qué tal con un ciclo for?
mini

for (i in rownames(mini)) {
   t = t.test(mini[i,1:3], mini[i,4:6])

   print(i)
   print(t$p.value)  # Si queremos el resultado completo, podemos imprimir el valor de 't'
}
[1] "1416660_at"
[1] 0.06123795
[1] "1422075_at"
[1] 0.7057916
[1] "1439154_at"
[1] 0.5597596
En este caso vamos a evitar la complejidad de utilizar algo como apply, y veremos cómo calcular todos los p-values (de acuerdo a una prueba de t) para nuestros datos de expresión. Dado que va a hacer 10,000 pruebas, esto se puede demorar un poco.
exprNorm$p.value = 1

for (i in rownames(exprNorm)) {
   exprNorm[i,"p.value"] = t.test(exprNorm[i,1:3], exprNorm[i,4:6])$p.value
}

head(exprNorm)
               ko1   ko2   ko3   wt1   wt2   wt3    p.value
1416660_at    5.56  5.57  5.67  5.41  5.19  5.43 0.06123795
1422075_at   -0.91 -0.86 -1.20 -0.99 -0.92 -0.92 0.70579158
1439154_at    3.31  3.23  3.23  3.31  3.18  3.44 0.55975963
1457741_at   -1.02 -1.00 -1.08 -0.95 -1.26 -1.03 0.66980209
1455205_a_at  3.82  3.92  4.02  3.80  3.66  3.84 0.12602410
1451253_at    1.47  1.68  1.84  1.94  1.90  1.98 0.11703935
Podriamos inclusive guardar los puros p.values con los nombres de los genes, parecido al primer ejercicio que hicimos con edades:
pvals = exprNorm$p.value

names(pvals) = rownames(exprNorm)

head(pvals)
  1416660_at   1422075_at   1439154_at   1457741_at 1455205_a_at   1451253_at
  0.06123795   0.70579158   0.55975963   0.66980209   0.12602410   0.11703935
Para entender el problema con el análisis anterior, puede ser más fácil realizar un experimento. Qué tal si en lugar de usar una tabla de valores reales de expresión, simulamos valores aleatorios?
R tiene una bateria muy grande de funciones para trabajar con esto, pero por ahora solo vamos a usar una de las más sencillas, que nos permite generar números aleatorios de una distribución normal. Pueden consultar su ayuda con ?rnorm.
rnorm(5)    # si no especificamos parametros, usa mean=0, sd=1)

rnorm(5, mean=10, sd=2)
[1]  0.3545978 -1.9661450  0.9344630 -0.3965833  1.2821925

[1]  9.901565 11.506199 12.854603 10.874258  9.215825
Ahora generemos una tabla de expresión aleatoria, pero con el mismo número de datos que nuestro experimento:
randExpr = expr

for (i in 1:ncol(randExpr)) {
   randExpr[,i] = rnorm(nrow(randExpr), mean=5, sd=1)
}

boxplot(randExpr, col=rainbow(ncol(randExpr)), main="Random expression")
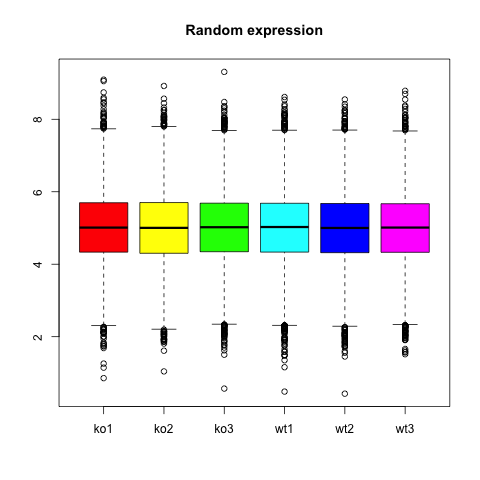
Quizá demasiado simétrico, pero nos sirve. Repitamos ahora todo el ejercicio de obtener p.values para cada uno de los "genes" con expresión aleatoria.
randExpr$p.value = 1

for (i in rownames(randExpr)) {
   randExpr[i,"p.value"] = t.test(randExpr[i,1:3], randExpr[i,4:6])$p.value
}

randPvals = randExpr$p.value

names(randPvals) = rownames(randExpr)

head(randPvals)
  1416660_at   1422075_at   1439154_at   1457741_at 1455205_a_at   1451253_at
  0.19576006   0.72234192   0.07783196   0.68217867   0.47030825   0.39960256