En esta práctica vamos a analizar un experimento muy sencillo de RNA-Seq, usando el paquete edgeR de Bioconductor. Este paquete contiene uno de los métodos más populares para analizar expresión diferencial para datos de secuenciación. Los datos de "cuentas" se modelan usando la distribución Binomial Negativa, que se ha visto que se ajusta mucho mejor a este tipo de datos que la Poisson que se usaba en un principio.
El paquete edgeR nos permite analizar experimentos bastante complejos, pero para esta práctica solo usaremos un conjunto sencillo de datos, una comparación entre Hígado y Riñón de humano. Estos fueron secuenciados en un Illumina GA por Marioni, et al. y descritos en el siguiente trabajo:
La Tabla Suplementaria 2 contiene las cuentas de lecturas agregadas de acuerdo a su mapeo contra los genes de Ensembl. Para esta práctica usaremos solo las primeras 7 muestras, consistiendo de 3 Riñón y 4 Hígados (el 8vo carril contiene un control).
Por favor descarguen el archivo: Marioni_SuppTable2.txt.zip
Recuerden que este archivo necesita ser descomprimido y colocando en su directorio de trabajo de R.
Primero necesitan iniciar R y cargar el paquete:
library(edgeR)
Vale la pena mencionar que este no es un tutorial muy completo, si no una vista rápida a algunas de las posibilidades. Es muy recomendable que revisen el manual completo de edgeR, el cual incluye varios ejemplos explicados y lo pueden abrir así:
edgeRUsersGuide()

# Nota: necesitan tener edgeR version 2.6.5 o superior, de lo contrario usen help.start()
counts = read.table("Marioni_SuppTable2.txt", header=TRUE, row.names=1)

head(counts)
                Kidney.1 Liver.2 Kidney.3 Liver.4 Liver.6 Kidney.7 Liver.8
ENSG00000146556        0       0        0       0       0        0       0
ENSG00000197194        0       0        0       0       0        0       0
ENSG00000197490        0       0        0       0       0        0       0
ENSG00000205292        0       0        0       0       0        0       0
ENSG00000177693        0       0        0       0       0        0       0
ENSG00000209338        0       0        0       0       0        0       0
Pueden ver muchos ceros, pero regresaremos a ello más adelante...
Cuántas muestras hay? Cuántos genes?
dim(counts)
[1] 32000 7
Claramente hay muchos genes que nunca fueron mapeadas, ni siquiera por un fragmento de alguno de las bibliotecas. Conviene quitar estos genes, al igual que aquellos que fueron secuenciados a niveles muy muy bajos. De todos modos no vamos a poder decir nada interesante (estadísticamente) sobre ellos!
La función cpm nos calcula counts per million, es decir, divide entre el total de cada columna (muestra) y lo multiplica por 1 millón.
counts = counts[rowSums(cpm(counts) >= 5) >= 2,]

dim(counts)
[1] 13265 7
También tenemos que decirle a edgeR como se encuentran agrupadas las muestras, en nuestro caso queremos distinguir entre dos tipos de tejido. Podemos definir esto a mano, pero es mas fácil usar una función de R para sustituir (en este caso eliminar) algún texto de otro texto. ('.' significa cualquier caracter, '$' significa final de línea)
colnames(counts)

grp = sub("..$", "", colnames(counts))

grp
[1] "Kidney.1" "Liver.2"  "Kidney.3" "Liver.4"  "Liver.6"  "Kidney.7" "Liver.8"

[1] "Kidney" "Liver"  "Kidney" "Liver"  "Liver"  "Kidney" "Liver"
Ahora podemos combinar todo esto:
dge = DGEList(counts=counts, group=grp)

dge
An object of class "DGEList"
$samples
          group lib.size norm.factors
Kidney.1 Kidney  1789440            1
Liver.2   Liver  1682034            1
Kidney.3 Kidney  1839511            1
Liver.4   Liver  1686546            1
Liver.6   Liver  1621487            1
Kidney.7 Kidney  1727889            1
Liver.8   Liver  1566378            1

$counts
                Kidney.1 Liver.2 Kidney.3 Liver.4 Liver.6 Kidney.7 Liver.8
ENSG00000209350        4      35        7      32      31        3      29
ENSG00000212679      110     177      131     135     141      149     148
ENSG00000212678    12685    9246    13204    9312    8746    12403    8496
ENSG00000187634       49      27       43      34      23       41      35
ENSG00000188976       73      34       77      56      45       68      55
13260 more rows ...

$all.zeros
ENSG00000209350 ENSG00000212679 ENSG00000212678 ENSG00000187634 ENSG00000188976
          FALSE           FALSE           FALSE           FALSE           FALSE
13260 more elements ...
Hay varias cosas que podemos hacer para explorar estos datos antes de proseguir, pero una de las más útiles es generar una imagen que nos permita identificar las relaciones entre todas las muestras. Una de las maneras es usar la función plotMDS, que realiza un análisis parecido a un PCA.
plotMDS(dge)
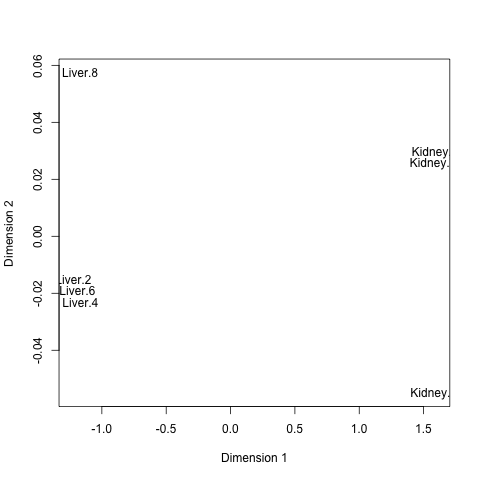
Podemos ver que las muestras de cada tejido se separan bastante bien, en este caso en la primera dimensión.
La mayoría de los mejores métodos para analizar expresión diferencial basada en datos de cuentas (números enteros) consideran que no se deben modificar estas cuentas directamente para normalizarlas. En lugar de esto, se calculan factores de normalización que luego son usadas internamente por el modelo. Esto es bastante sencillo de hacer dentro de edgeR, aunque si hay muchas opciones que pueden ser modificadas para casos especiales.
dge = calcNormFactors(dge)

dge$samples
          group lib.size norm.factors
Kidney.1 Kidney  1789440    1.2824730
Liver.2   Liver  1682034    0.8274582
Kidney.3 Kidney  1839511    1.2899479
Liver.4   Liver  1686546    0.8292361
Liver.6   Liver  1621487    0.8252799
Kidney.7 Kidney  1727889    1.2923124
Liver.8   Liver  1566378    0.8260124
Podemos realizar un diagnóstico visual sobre los cambios de expresión entre cualquier par de muestras (tomemos las primeras dos). Figuras de tipo MA han sido populares desde el tiempo de los microarreglos, y comparan el log de la Abundancia (en este caso cuentas de lecturas mapeadas) en el eje X contra el log Fold-change (diferencia de expresión) en el eje Y.
maPlot(dge$counts[,1], dge$counts[,2])
Para facilitar la interpretación podemos agregar una gradilla y una linea de tendencia, mostrando la diferencia entre los dos factores de normalización de las mismas bibliotecas.
grid(col = "blue")
abline(h = log2(dge$samples$norm.factors[2]/dge$samples$norm.factors[1]), col="red", lwd=2)
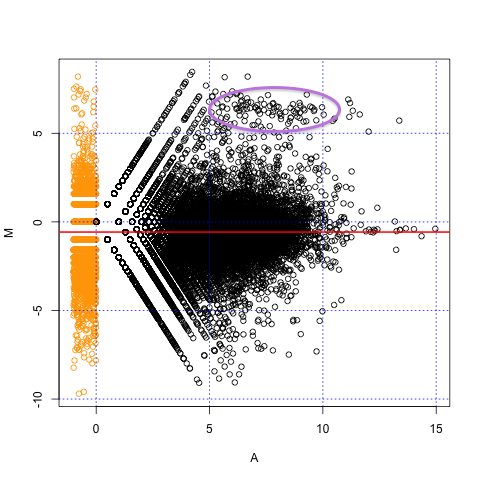
El bulto de los genes parece tener log Fold-changes negativos, lo cual sugeriría que la mayoría de los genes se expresan más altamente en riñón comparado con hígado. Esto es poco probable que sea la realidad biológica, otra explicación siendo que hay un subconjunto de genes muy altamente expresados en hígado (encerrados en el óvalo morado) que están acaparando muchas de las lecturas, dejando el resto de los genes subrepresentados. Los factores de normalización pueden corregir este efecto, como podemos ver mediante el valor negativo de la línea roja (que representa el centro de los datos después de normalizar).
Para hacer un análisis de expresión diferencial necesitamos estimar la dispersión de nuestros datos, y luego hacer una prueba para buscar diferencias entre nuestros dos tejidos.
dge = estimateCommonDisp(dge)

et = exactTest(dge, dispersion=dge$common.dispersion)
Después podemos interrogar los genes más diferencialmente expresados:
topTags(et)
Comparison of groups:  Liver-Kidney
                    logFC    logCPM PValue FDR
ENSG00000105697  8.514453  8.098067      0   0
ENSG00000141485  8.344629  9.251094      0   0
ENSG00000134391  8.002654  7.573499      0   0
ENSG00000139547  7.860641  9.643655      0   0
ENSG00000151490 -7.849813  7.586220      0   0
ENSG00000151224  7.812275 11.464031      0   0
ENSG00000123843  7.771028  7.880559      0   0
ENSG00000197901 -7.702878  7.046667      0   0
ENSG00000005421  7.691921  7.382464      0   0
ENSG00000140505  7.683381  8.561442      0   0
Estos pocos genes tienen una confianza estadística excelente. Probablemente querramos ver una lista má grande y compelta de genes. Generalmente es más fácil obtener la evaluación estadística de todos los genes y después elegir los umbrales de corte a utilizar.
deTab = topTags(et, n=Inf)$table

head(deTab)
                    logFC    logCPM PValue FDR
ENSG00000105697  8.514453  8.098067      0   0
ENSG00000141485  8.344629  9.251094      0   0
ENSG00000134391  8.002654  7.573499      0   0
ENSG00000139547  7.860641  9.643655      0   0
ENSG00000151490 -7.849813  7.586220      0   0
ENSG00000151224  7.812275 11.464031      0   0
Podemos elegir ahora genes que tienen un P-valor ajustado de menos de 0.01 (esto representa la fracción de falsos positivos) y una magnitud de cambio (log Fold-change) mayor a 1 (fuera de escala log2, mayor a 2).
deGenes = rownames(deTab)[deTab$FDR < 0.01 & abs(deTab$logFC) > 1]

head(deGenes)

length(deGenes)
[1] "ENSG00000105697" "ENSG00000141485" "ENSG00000134391" "ENSG00000139547" "ENSG00000151490" "ENSG00000151224"

[1] 5132
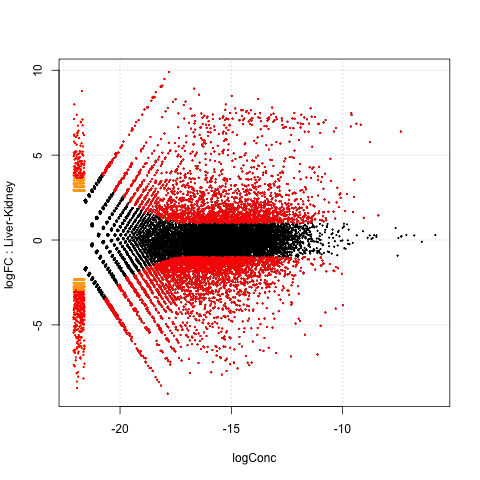
Hay otra figura que puede ayudarnos a observar los genes que estamos encontrando como diferencialmente expresados:
plotSmear(dge, de.tags=deGenes)
Finalmente, podemos guardar la tabla completa de nuestros resultados de expresión diferencial. Podemos hacerlo así:
write.table(deTab, file="DiffExp_edgeR.txt", sep="\t")
Ejercicios: