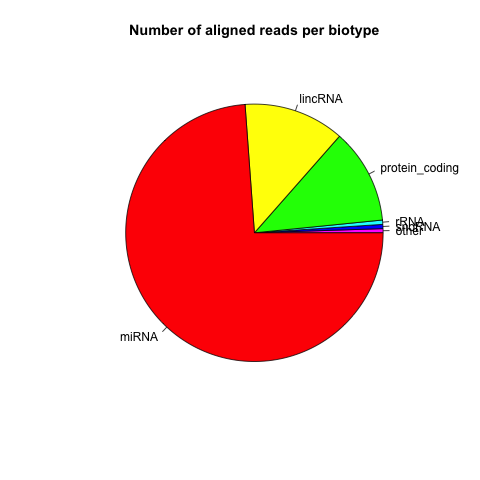
El propósito de estos ejercicios es obtener la anotación del genoma con el que estamos trabajando, y utilizar esta anotación para catalogar nuestro mapeo de la secuenciación masiva. El resultado de esta práctica será obtener una figura mostrando la frecuencia con la que hemos secuenciado fragmentos de distintos tipos de elementos genómicos (regiones codificantes, miRNAs, rRNA, snoRNA, etc). Haremos todo esto dentro del ambiente de R/Bioconductor.
Exactamente el mismo principio puede aplicarse a proyectos sin un genoma completo, siempre y cuando se cuente con algún tipo de archivo describiendo la anotación de distintas regiones de las secuencias de referencia (contigs, ESTs, cDNAs, etc).
Durante esta práctica vamos a utilizar:
| R y BioConductor | Instalados |
| Paquetes de BioC: IRanges, rtracklayer, GenomicRanges, Rsamtools | Instalados |
En esta práctica manipularemos muchos datos que se nos presentan en forma de rangos (coordenadas de genes, posiciones de secuencias mapeadas, etc). Una de las maneras más flexibles de hacer esto en R es aprovechando el paquete IRanges.
library(Biobase)
library(IRanges)
Podemos generar un objecto de clase IRanges si sabemos los inicios y finales de cada rango:
x = IRanges(start=c(11,35,40), end=c(20,50,63))

x
IRanges of length 3
    start end width
[1]    11  20    10
[2]    35  50    16
[3]    40  63    24
Para extraer la información básica de estos rangos usamos:
start(x) # Todos los inicios
end(x)   # Todos los finales
width(x) # Ancho de cada rango
range(x) # Rango total de todos
Pero existen muchas más funciones de gran utilidad:
coverage(x) # La suma de la cobertura en cada posición
'integer' Rle of length 63 with 6 runs
  Lengths: 10 10 14  5 11 13
  Values :  0  1  0  1  2  1
reduce(x) # Une los rangos que estan encimados
IRanges of length 2
    start end width
[1]    11  20    10
[2]    35  63    29
y para darles una idea de lo que pretendemos:
exons = reduce(x)

reads = IRanges(start=c(1,21,30,50,80), width=20)

reads
IRanges of length 5
    start end width
[1]     1  20    20
[2]    21  40    20
[3]    30  49    20
[4]    50  69    20
[5]    80  99    20
countOverlaps(exons, reads)
[1] 1 3
Para mayores detalles, les recomiendo el vignette de IRanges (openVignette(package="IRanges")).
Lo primero que necesitamos es información sobre los elementos que nos interesa analizar de un genoma. En este caso nos interesa trabajar únicamente con genes conocidos del genoma humano. Para cada uno de estas regiones anotadas del genoma, necesitamos saber sus coordenadas y la cadena en la que se encuentran. También nos conviene saber el tipo biológico de cada transcrito, si representa una proteina, o un RNA no codificante.
Existen muchas maneras de obtener este tipo de información. En este caso podemos descargar de Ensembl un archivo GTF (Gene Transfer Format) que contiene toda la anotacion del genoma humano. Descarguen el archivo localmente: Homo_sapiens_exons_sel_e70.gtf.zip y descomprímanlo en su directorio de trabajo.
Usaremos la funcionalidad del paquete rtracklayer para importar este archivo a R.
library(rtracklayer)

# Cuidado! Importar el archivo completo puede requerir ~2-3 GB de RAM.
human = import("Homo_sapiens_exons_sel_e70.gtf", asRangedData = FALSE)

human
Para aquellos que no tengan suficiente memoria, pueden utilizar una versión más chica del archivo: Homo_sapiens_exons_small_e70.gtf.zip o pueden intentar descargar el siguiente archivo: human.Rdata y cargarlo dentro de R:
load("human.Rdata")
human
GRanges with 852534 ranges and 11 metadata columns:
                    seqnames                 ranges strand   |         source     type     score     phase
                       <Rle>              <IRanges>  <Rle>   |       <factor> <factor> <numeric> <integer>
       [1] HG104_HG975_PATCH [144766623, 144766712]      +   | protein_coding     exon      <NA>      <NA>
       [2] HG104_HG975_PATCH [144772227, 144772293]      +   | protein_coding     exon      <NA>      <NA>
       [3] HG104_HG975_PATCH [144773243, 144773369]      +   | protein_coding     exon      <NA>      <NA>
...
                   gene_id   transcript_id exon_number   gene_name   gene_biotype transcript_name         exon_id
               <character>     <character>   <numeric> <character>    <character>     <character>     <character>
       [1] ENSG00000261516 ENST00000564532           1      ZNF707 protein_coding      ZNF707-003 ENSE00002607083
       [2] ENSG00000261516 ENST00000564532           2      ZNF707 protein_coding      ZNF707-003 ENSE00003182566
       [3] ENSG00000261516 ENST00000564532           3      ZNF707 protein_coding      ZNF707-003 ENSE00003068724
El objecto que hemos creado es de clase GRanges y es muy util para guardar información acerca de coordenadas genómicas.
Podemos obtener acceso a los componentes de este nuevo objecto:
seqnames(human)
ranges(human)
strand(human)
mcols(human)
Lo último corresponde a una tabla donde podemos tener todas las columnas que querramos con información extra.
Podemos manipular los datos sencillamente:
table(mcols(human)$gene_biotype)
       lincRNA          miRNA       misc_RNA        Mt_rRNA        Mt_tRNA
         27478           3401           2187              2             22

    non_coding protein_coding           rRNA         snoRNA          snRNA
            61         815138            566           1613           2066
Evidentemente hay muchas más columnas de anotación de lo que necesitamos. Podemos seleccionar solamente algunas:
mcols(human) = mcols(human)[,c("source","gene_id","gene_name","gene_biotype")]

mcols(human)
DataFrame with 852534 rows and 4 columns
               source         gene_id   gene_name   gene_biotype
             <factor>     <character> <character>    <character>
1      protein_coding ENSG00000261516      ZNF707 protein_coding
2      protein_coding ENSG00000261516      ZNF707 protein_coding
3      protein_coding ENSG00000261516      ZNF707 protein_coding
...
Ejercicios:
El siguiente paso es cargar la información de las posiciones de mapeo de todos nuestros datos de secuenciación. Vamos a utilizar los resultados de alinear secuencias filtradas como en el ejercicio anterior contra el genoma humano. Pueden descargar el archivo BAM desde aquí: human_mapped.bam
Los que quieran utilizar un archivo mucho más chico, pueden descargar: human_mapped_small.bam
Vamos a utilizar el paquete Rsamtools cuando tengamos que importar datos de archivos SAM/BAM. Para no importar absolutamente toda la información del archivo BAM, vamos a seleccionar cuáles datos queremos. Finalmente vamos a querer guardarlos en un objeto GRanges, por lo que necesitamos el nombre del cromosoma (o secuencia de referencia), la cadena, la posición y la longitud de la secuencia que fue mapeada.
library(Rsamtools)

what = c("rname", "strand", "pos", "qwidth")
param = ScanBamParam(what=what)

bam = scanBam("human_mapped.bam", param=param)

class(bam)

lapply(bam, names)
[1] "list"

[[1]]
[1] "rname"  "strand" "pos"    "qwidth"
La función scanBam nos provee de una interfase muy cruda, pero flexible, a los datos de un archivo BAM. El resultado viene como una lista de listas, porque la función permite limitar la extracción de datos a solamente ciertos rangos (el primer nivel de la lista), además de extraer solamente ciertos campos (el segundo nivel de la lista, que en este caso sí especificamos).
Podemos construir un GRanges con estos datos:
mapGR = GRanges(
   seqnames = bam[[1]]$rname,
   ranges   = IRanges(start=bam[[1]]$pos, width=bam[[1]]$qwidth),
   strand   = bam[[1]]$strand
)

mapGR
GRanges with 7877511 ranges and 0 metadata columns:
              seqnames                 ranges strand
                 <Rle>              <IRanges>  <Rle>
        [1]          5 [148808541, 148808560]      +
        [2]          5 [148808541, 148808562]      +
        [3]          9 [139565105, 139565126]      +
        ...        ...                    ...    ...
  [7877509]          6 [ 72086706,  72086729]      -
  [7877510]          3 [ 52302352,  52302374]      -
  [7877511]          X [151128148, 151128171]      -
  ---
  seqlengths:
            1         10         11         12         13 ...
           NA         NA         NA         NA         NA ...
Con la función countOverlaps podemos encontrar cuantas secuencias alineadas traslapan con cada uno de nuestras anotaciones. De una vez guardamos el resultado directamente como una columna adicional de las anotaciones:
ADVERTENCIA. Aunque no lo vamos a tomar en cuenta aquí, muchos de los rangos de nuestra tabla podrían estar contenidos unos dentro de otros. Como lo que queremos es contar ocurrencias de nuestras secuencias cortas dentro de estos rangos, podríamos terminar contando algunas de las secuencias más de una vez.
mcols(human)$counts = countOverlaps(human, mapGR)

mcols(human)
DataFrame with 852534 rows and 5 columns
               source         gene_id   gene_name   gene_biotype    counts
             <factor>     <character> <character>    <character> <integer>
1      protein_coding ENSG00000261516      ZNF707 protein_coding         0
2      protein_coding ENSG00000261516      ZNF707 protein_coding         0
3      protein_coding ENSG00000261516      ZNF707 protein_coding         0
...
Por ahora ignoren un Warning si les sale, se refiere a que no coinciden absolutamente todos los nombres de los cromosomas en los objetos que estamos comparando. Esto es normal, pues no tiene forzosamente que haber secuencias alineando en todos los cromosomas, ni una anotación conocida en cada uno de ellos.
Finalmente, podemos agregar estos valores de la manera que más nos convenga. En este caso podría ser por tipo de gen, o por gen individual.
typeCounts = aggregate(mcols(human)$counts, by=list("biotype"=mcols(human)$gene_biotype), sum)

typeCounts
          biotype       x
1         lincRNA 1117980
2           miRNA 6522639
3        misc_RNA   11385
4         Mt_rRNA   13617
5         Mt_tRNA   18651
6      non_coding     177
7  protein_coding 1053202
8            rRNA   47733
9          snoRNA   46574
10          snRNA    2061
geneCounts = aggregate(mcols(human)$counts, by=list("id"=mcols(human)$gene_name), sum)

head(geneCounts)
         id  x
1 100507229  0
2 100652820  0
3   5S_rRNA  1
4    61E3.4  4
5       7SK 80
6 A-575C2.4  1
Las cuentas por gen las podríamos usar directamente en un proceso de análisis de expresión diferencial, por ejemplo. La distribución de secuencias cortas en los distinto biotipos podríamos querer visualizarlo en una figura:
minCount = 40000
typeCountsHigh = typeCounts[typeCounts$x > minCount,]
typeCountsHigh = typeCountsHigh[order(typeCountsHigh$x),]
typeCountsHigh = rbind(data.frame("biotype"="other",
                           "x"=sum(typeCounts$x[typeCounts$x <= minCount])),
                           typeCountsHigh)

pie(typeCountsHigh$x, labels=typeCountsHigh$biotype, col=rev(rainbow(nrow(typeCountsHigh))),
    main="Number of aligned reads per biotype")