El propósito de estos ejercicios es obtener la anotación del genoma con el que estamos trabajando, y utilizar esta anotación para catalogar nuestro mapeo de la secuenciación masiva. El resultado de esta práctica será obtener una figura mostrando la frecuencia con la que hemos secuenciado fragmentos de distintos tipos de elementos genómicos (exones codificantes y no-codificantes, regiones 5'UTR y 3'UTR, intrones, etc). Haremos todo esto dentro del ambiente de R/Bioconductor.
Durante esta práctica vamos a utilizar:
| R y BioConductor | Instalados |
| Paquetes de BioC: IRanges, biomaRt, ShortRead, GenomicRanges | Instalados |
En esta práctica manipularemos muchos datos que se nos presentan en forma de rangos (coordenadas de genes, posiciones de secuencias mapeadas, etc). Una de las maneras más flexibles de hacer esto en R es aprovechando el paquete IRanges.
library(Biobase)
library(IRanges)
Podemos generar un objecto de clase IRanges si sabemos los inicios y finales de cada rango:
x <- IRanges(start=c(11,35,40), end=c(20,50,63))

x
IRanges of length 3
    start end width
[1]    11  20    10
[2]    35  50    16
[3]    40  63    24
Para extraer la información básica de estos rangos usamos:
start(x) # Todos los inicios
end(x)   # Todos los finales
width(x) # Ancho de cada rango
range(x) # Rango total de todos
Pero existen muchas más funciones de gran utilidad:
coverage(x) # La suma de la cobertura en cada posición
'integer' Rle of length 63 with 6 runs
  Lengths: 10 10 14  5 11 13
  Values :  0  1  0  1  2  1
reduce(x) # Une los rangos que estan encimados
IRanges of length 2
    start end width
[1]    11  20    10
[2]    35  63    29
y para darles una idea de lo que pretendemos:
exons <- reduce(x)

reads  <- IRanges(start=c(1,21,30,50,80), width=20)

reads
IRanges of length 5
    start end width
[1]     1  20    20
[2]    21  40    20
[3]    30  49    20
[4]    50  69    20
[5]    80  99    20
countOverlaps(exons, reads)
[1] 1 3
Para mayores detalles, les recomiendo el vignette de IRanges (openVignette(package="IRanges")).
Lo primero que necesitamos es información sobre los elementos que nos interesa analizar de un genoma. Por ahora trabajaremos únicamente con genes conocidos, sus regiones 5' y 3'UTR, exones e intrones. Para cada uno de estas regiones anotadas del genoma, necesitamos saber sus coordenadas y la cadena en la que se encuentran. También nos conviene saber el tipo biológico de cada transcrito, si representa una proteina, o un RNA no codificante. Vamos a extraer toda esta información de Ensembl, utilizando biomaRt, que es la inferase en R a BioMart.
Por cuestiones de tiempo, veremos un ejemplo muy básico de como usar biomaRt y procederemos a bajar una serie de datos obtenidos previamente.
library(biomaRt)

mart <- useMart("ensembl", dataset="hsapiens_gene_ensembl")

# Los atributos que queremos obtener
attribs <- c("ensembl_transcript_id", "chromosome_name", "strand", "exon_chrom_start", "exon_chrom_end")

# Obtener la información de la bases de datos
transInfo <- getBM(attributes=attribs, filters="ensembl_transcript_id", values="ENST00000224764", mart=mart)

head(transInfo)
  ensembl_transcript_id chromosome_name strand exon_chrom_start exon_chrom_end
1       ENST00000224764              10      1         88598622       88598736
2       ENST00000224764              10      1         88649819       88649981
3       ENST00000224764              10      1         88651884       88651986
4       ENST00000224764              10      1         88659551       88659647
5       ENST00000224764              10      1         88659784       88659883
6       ENST00000224764              10      1         88671997       88672141
Si quieren ver la lista completa de los atributos que podemos extraer, usen la función listAttributes(mart). Con listFilters(mart) obtenemos una tabla con todos los filtros válidos. Si quieren aprender más, vienen varios ejercicios en el vignette que se instala junto con biomaRt (openVignette(package="biomaRt")).
Para continuar con la práctica, preparé una tabla usando biomaRt, pidiendo una lista más grande de atributos, pero solamente para el cromosoma 10 mediante los parámetros filters="chromosome_name" y values="10".
Bajen entonces la tabla con la anotación del cromosoma 10.
Leamos la tabla que bajaron en R y veamos que contiene:
coords <- read.table("human_chr10_annotation.tab.gz", header=TRUE, sep="\t", check.names=FALSE)

head(coords)
  ensembl_transcript_id ensembl_gene_id chromosome_name strand exon_chrom_start
1       ENST00000016171 ENSG00000014919           chr10      -        101491717
2       ENST00000016171 ENSG00000014919           chr10      -        101489310
3       ENST00000016171 ENSG00000014919           chr10      -        101487198
4       ENST00000016171 ENSG00000014919           chr10      -        101486725
5       ENST00000016171 ENSG00000014919           chr10      -        101483713
6       ENST00000016171 ENSG00000014919           chr10      -        101480744
  exon_chrom_end 3_utr_start 3_utr_end 5_utr_start 5_utr_end   gene_biotype
1      101491857          NA        NA   101491807 101491857 protein_coding
2      101489491          NA        NA          NA        NA protein_coding
3      101487320          NA        NA          NA        NA protein_coding
4      101486911          NA        NA          NA        NA protein_coding
5      101483880          NA        NA          NA        NA protein_coding
6      101480825          NA        NA          NA        NA protein_coding
  cds_chrom_start cds_chrom_end transcript_biotype
1       101491717     101491806     protein_coding
2       101489310     101489491     protein_coding
3       101487198     101487320     protein_coding
4       101486725     101486911     protein_coding
5       101483713     101483880     protein_coding
6       101480744     101480825     protein_coding
Hay una clase de objeto muy util para guardar información acerca de coordenadas genómicas, llamado GRanges. Para usarlo, necesitamos asegurarnos de tener cargado el paquete GenomicRanges.
library(GenomicRanges)

exonGRs <- GRanges(
   seqnames = Rle(factor(coords$chromosome_name)),
   ranges   = IRanges(start=coords$exon_chrom_start, end=coords$exon_chrom_end),
   strand   = Rle(factor(coords$strand)),
   biotype  = as.character(coords$transcript_biotype),
   id       = as.character(coords$ensembl_transcript_id)
)

exonGRs
GRanges with 46395 ranges and 2 elementMetadata values
        seqnames                 ranges strand   |        biotype              id
           <Rle>              <IRanges>  <Rle>   |    <character>     <character>
    [1]    chr10 [101491717, 101491857]      -   | protein_coding ENST00000016171
    [2]    chr10 [101489310, 101489491]      -   | protein_coding ENST00000016171
    [3]    chr10 [101487198, 101487320]      -   | protein_coding ENST00000016171
    ...      ...                    ...    ... ...            ...             ...
[46393]    chr10 [ 74774855,  74776047]      +   |        lincRNA ENST00000502140
[46394]    chr10 [131910186, 131910380]      +   |        lincRNA ENST00000502243
[46395]    chr10 [131918330, 131919006]      +   |        lincRNA ENST00000502243

seqlengths
 chr10
    NA
Podemos obtener acceso a los componentes de este nuevo objecto:
seqnames(exonGRs)
ranges(exonGRs)
strand(exonGRs)
values(exonGRs)
Lo último corresponde a una tabla donde podemos tener todas las columnas que querramos con información extra.
Podemos manipular los datos sencillamente:
table(values(exonGRs)$biotype)
              Mt_tRNA_pseudogene                          lincRNA                            miRNA
                              20                              168                               64
                        misc_RNA              misc_RNA_pseudogene                       non_coding
                              60                                1                               10
         nonsense_mediated_decay             processed_pseudogene             processed_transcript
                            1132                              487                             9593
                  protein_coding                       pseudogene                             rRNA
                           33460                              220                               27
                 rRNA_pseudogene                  retained_intron                  retrotransposed
                              14                              494                               13
                scRNA_pseudogene                            snRNA                 snRNA_pseudogene
                              34                               70                               23
                          snoRNA                snoRNA_pseudogene                  tRNA_pseudogene
                              40                               31                                3
transcribed_processed_pseudogene               unitary_pseudogene           unprocessed_pseudogene
                               2                               25                              404
Una advertencia. Aunque no lo vamos a tomar en cuenta aquí, muchos de los rangos de nuestra tabla podrían estar contenidos unos dentro de otros. Como lo que queremos es contar ocurrencias de nuestras secuencias cortas dentro de estos rangos, podríamos terminar contando algunas de las secuencias más de una vez.
Si cerraron su sesión de R después de la práctica anterior, vamos a tener que leer una vez más los resultados del alineamiento con Bowtie. Si no los tienen, pueden bajarlas de esta carpeta.
library(ShortRead)

aln <- readAligned("aln.bwt.gz", type="Bowtie")

aln
class: AlignedRead
length: 394773 reads; width: 15..31 cycles
chromosome: chr10 chr10 ... chr10 chr10
position: 82487667 76102535 ... 49380417 5014830
strand: - + ... - +
alignQuality: NumericQuality
alignData varLabels: similar mismatch
Lo primero que tenemos que hacer es convertir este objeto en uno que podamos comparar con nuestras coordenadas de exons:
alnGRs <- as(aln, "GRanges")

alnGRs
GRanges with 394773 ranges and 3 elementMetadata values
         seqnames                 ranges strand   |                      id   similar    mismatch
            <Rle>              <IRanges>  <Rle>   |            <BStringSet> <integer> <character>
     [1]    chr10 [ 82487667,  82487684]      -   |       HWI-E09:5:1:0:153        52       8:T>G
     [2]    chr10 [ 76102535,  76102550]      +   |      HWI-EA9:5:1:0:1091       158
     [3]    chr10 [107789720, 107789737]      +   |      HWI-EA9:5:1:0:1866         0       8:A>G
     ...      ...                    ...    ... ...                     ...       ...         ...
[394771]    chr10 [ 11113524,  11113540]      -   | HWI-EASXXX:00:1781:1467         0      15:T>C
[394772]    chr10 [ 49380417,  49380431]      -   | HWI-EASXXX:00:1781:1107         2       9:C>G
[394773]    chr10 [  5014830,   5014855]      +   |   HWI-EASXX:100:1781:61         1

seqlengths
 chr10
    NA
Con la función countOverlaps podemos encontrar cuantas secuencias alineadas traslapan con cada uno de nuestros exones. De una vez guardamos el resultado directamente como anotación de los exones:
values(exonGRs)$counts <- countOverlaps(exonGRs, alnGRs)

values(exonGRs)
DataFrame with 46395 rows and 3 columns
             biotype              id    counts

1     protein_coding ENST00000016171         1
2     protein_coding ENST00000016171        12
3     protein_coding ENST00000016171         0
...              ...             ...       ...
46393        lincRNA ENST00000502140         1
46394        lincRNA ENST00000502243         0
46395        lincRNA ENST00000502243         0
Finalmente, podemos agregar estos valores de la manera que más nos convenga. En este caso podría ser por tipo de transcrito, o por transcrito individual.
typeCounts <- aggregate(values(exonGRs)$counts, by=list("biotype"=values(exonGRs)$biotype), sum)

head(typeCounts)
              biotype   x
1  Mt_tRNA_pseudogene 654
2             lincRNA 453
3               miRNA 163
4            misc_RNA 517
5 misc_RNA_pseudogene   0
6          non_coding   5
transCounts <- aggregate(values(exonGRs)$counts, by=list("id"=values(exonGRs)$id), sum)

head(transCounts)
               id   x
1 ENST00000016171  38
2 ENST00000020673  10
3 ENST00000173785  12
4 ENST00000181796 123
5 ENST00000185885   0
6 ENST00000185907   1
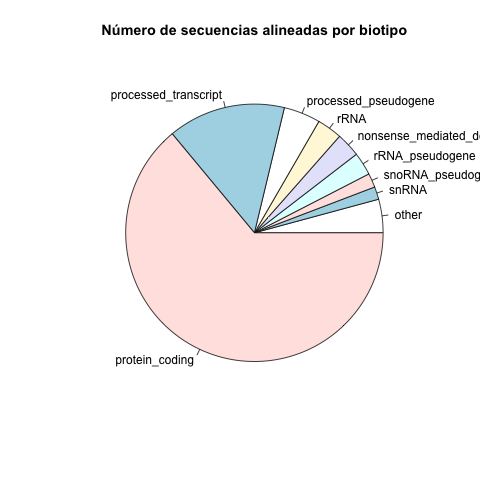
Las cuentas por transcrito las podríamos usar directamente en un proceso de análisis de expresión diferencial, por ejemplo. La distribución de secuencias cortas en los distinto biotipos podríamos querer visualizarlo en una figura:
minCount <- 1000
typeCountsHigh <- typeCounts[typeCounts$x > minCount,]
typeCountsHigh <- typeCountsHigh[order(typeCountsHigh$x),]
typeCountsHigh <- rbind(data.frame("biotype"="other",
                           "x"=sum(typeCounts$x[typeCounts$x <= minCount])),
                           typeCountsHigh)

pie(typeCountsHigh$x, labels=typeCountsHigh$biotype,
    main="Número de secuencias alineadas por biotipo")