En esta práctica veremos como alinear secuencias cortas a un genoma con Bowtie, que es uno de los alineadores más populares del momento por su velocidad y eficiencia de uso de memoria. Para los que esten interesados en los algoritmos usados por esta nueva generación de alineadores, les recomiendo la publicación original de Bowtie (Bowtie.pdf). Este y otros alineadores utilizan el "Burrows-Wheeler transform" para comprimir la secuencia genómica, permitiendo que hasta el genoma humano puedan ser procesado en máquinas con ~2-4 GB de RAM. La Wikipedia tiene una descripción básica de este algoritmo (Burrows-Wheeler_transform).
Durante esta práctica vamos a utilizar:
| R y BioConductor | Instalados |
| Paquetes de BioC: ShortRead, rtracklayer | Instalados |
| Bowtie | Instalado (descargar si no lo tienen) |
| Archivos FASTQ para alinear | Al menos un archivo de esta carpeta |
| Genoma de referencia | Cromosoma 10 humano |
Recuerden que vamos a necesitar al menos un archivo FASTQ y una secuencia de referencia. Asegúrense de ya haberlos bajado y descomprimido.
Bowtie tiene dos programas que vamos a usar: bowtie y bowtie-build. Con este último tendremos que pre-procesar cualquier secuencia de referencia que vayamos a usar. Para ver las opciones, simplemente ejecutamos:
bowtie-build
Usage: bowtie-build [options]* <reference_in> <ebwt_outfile_base>
    reference_in            comma-separated list of files with ref sequences
    ebwt_outfile_base       write Ebwt data to files with this dir/basename
Options:
    -f                      reference files are Fasta (default)
    -c                      reference sequences given on cmd line
    -C/--color              build a colorspace index
    -a/--noauto             disable automatic -p/--bmax/--dcv memory-fitting
    -p/--packed             use packed strings internally; slower, uses less mem
    -B                      build both letter- and colorspace indexes
    --bmax <int>            max bucket sz for blockwise suffix-array builder
    --bmaxdivn <int>        max bucket sz as divisor of ref len (default: 4)
    --dcv <int>             diff-cover period for blockwise (default: 1024)
    --nodc                  disable diff-cover (algorithm becomes quadratic)
    -r/--noref              don't build .3/.4.ebwt (packed reference) portion
    -3/--justref            just build .3/.4.ebwt (packed reference) portion
    -o/--offrate <int>      SA is sampled every 2^offRate BWT chars (default: 5)
    -t/--ftabchars <int>    # of chars consumed in initial lookup (default: 10)
    --ntoa                  convert Ns in reference to As
    --seed <int>            seed for random number generator
    -q/--quiet              verbose output (for debugging)
    -h/--help               print detailed description of tool and its options
    --usage                 print this usage message
    --version               print version information and quit
A pesar de que ahorita no vamos a usar estas opciones, vale la pena notar que Bowtie permite preparar una referencia para ser procesado en el colorspace de ABI SOLiD.
Si llegan a necesitar que bowtie localice secuencias altamente repetidas en un genoma, con mayor velocidad, pero usando más memoria, pueden decrementar el parámetro --offrate a 3 o 2.
Finalmente, como no tenemos datos de secuenciación de extremos apareados, podemos ahorrar espacio en disco utilizando la opción --noref.
Preparemos entonces nuestra secuencia de referencia:
bowtie-build --noref chr10.fa chr10
(tardará 5-10 minutos)
Settings:
  Output files: "chr10.*.ebwt"
  Line rate: 6 (line is 64 bytes)
  Lines per side: 1 (side is 64 bytes)
  Offset rate: 5 (one in 32)

...

    numSides: 586228
    numLines: 586228
    ebwtTotLen: 37518592
    ebwtTotSz: 37518592
Total time for backward call to driver() for mirror index: 00:02:45
Si tuvieron algun problema en este paso, pueden bajar los archivos de salida de esta carpeta.
Del mismo modo, podemos ver que bowtie tiene muchas opciones:
bowtie
de las cuales solamente muestro algunas de las más importantes:
Usage:
  bowtie [options]* <ebwt> {... <s>} [<hit>]
  <hit>   File to write hits to (default: stdout)
  <s>     Comma-separated list of files containing unpaired reads, or the
          sequences themselves, if -c is set.  Specify "-" for stdin.

Input:
  -q                 query input files are FASTQ .fq/.fastq (default)
  -f                 query input files are (multi-)FASTA .fa/.mfa
  -C                 reads and index are in colorspace
  -5/--trim5 <int>   trim <int> bases from 5' (left) end of reads
  --phred64-quals    input quals are Phred+64 (same as --solexa1.3-quals)

Alignment:
  -v <int>           report end-to-end hits w/ <=v mismatches; ignore qualities
    or
  -n/--seedmms <int> max mismatches in seed (can be 0-3, default: -n 2)
  --nofw/--norc      do not align to forward/reverse-complement reference strand

Reporting:
  -k <int>           report up to <int> good alignments per read (default: 1)
  -a/--all           report all alignments per read (much slower than low -k)
  --best             hits guaranteed best stratum; ties broken by quality

Output:
  -t/--time          print wall-clock time taken by search phases
  --al <fname>       write aligned reads/pairs to file(s) <fname>
  --un <fname>       write unaligned reads/pairs to file(s) <fname>
  --suppress <cols>  suppresses given columns (comma-delim'ed) in default output

SAM:
  -S/--sam           write hits in SAM format

Performance:
  -p/--threads <int> number of alignment threads to launch (default: 1)
Por ejemplo, para comparar nuestras secuencias contra el chromosoma 10, permitiendo un máximo de 1 mismatch (ignorando calidad), con el mejor match por secuencia (pero sólo reportando 1 de ellos) y especificando que nuestros valores de calidad son de tipo Phred64, usamos:
bowtie -v 1 --best -k 1 --phred64-quals chr10 secuencias.fq aln.bwt
Se puede realizar este paso sin descomprimir las secuencias:
gzip -dc secuencias.fq.gz | bowtie -v 1 --best -k 1 --phred64-quals chr10 - aln.bwt
(tardará ~2 minutos)
# reads processed: 3263918
# reads with at least one reported alignment: 394773 (12.10%)
# reads that failed to align: 2869145 (87.90%)
Reported 394773 alignments to 1 output stream(s)
Como ven, procesó más de 3 millones de secuencias en cuestión de minutos. Ahorita no nos preocupa que un porcentaje chico haya alineado, puesto que sólo estamos usando el cromosoma 10. Esperamos que la mayoría de las secuencias que no alinearon correspondan a alguno de los otros cromosomas.
Nuevamente, si tuvieron algun problema en este paso, pueden bajar la salida de esta carpeta.
Veamos qué contiene el archivo de salida de Bowtie:
head aln.bwt
HWI..53   -  chr10 82487666    ACTGCTCTCGTCAAAGCT   =B3CB6+)=,:51AB?=4   52   8:T>G
HWI..91   +  chr10 76102534    GTTTGTGTGTGTGTGT     >7B?02:6=6A58;;;     158
HWI..66   +  chr10 107789719   AAAAGGTCGAAGAAGTTA   +A9)6@9C+90,25B>7@   0    8:A>G
HWI..96   +  chr10 134657385   GGGGTTCTCAGGGTGCTG   *(8=@)@55((&7?@A;7   0    2:T>G
HWI..76   +  chr10 24407979    CTCATACATTACTTAC     ?BC=8')/>C>-><'?     0    6:A>C
Las columnas son:
Si no queremos tanta información, podemos ahorrar espacio de disco restringiendo las columnas que Bowtie nos regresa, con la opción --suppress, dándole el número de las columnas que no necesitamos.
La columna número 7 nos permite saber qué tan única o repetida es la posición en el genoma. En ciertas condiciones, esto es equivalente a saber el número de lugares en los que nuestras secuencias cortas puede alinear.
El paquete ShortRead también contiene funciones para procesar archivos de alineamientos de secuencias cortas. Veamos cómo funciona:
R
library(ShortRead)

alnFile <- "aln.bwt"

aln <- readAligned(alnFile, type="Bowtie")

aln
class: AlignedRead
length: 394773 reads; width: 15..31 cycles
chromosome: chr10 chr10 ... chr10 chr10
position: 82487667 76102535 ... 49380417 5014830
strand: - + ... - +
alignQuality: NumericQuality
alignData varLabels: similar mismatch
Este objecto es muy parecido al de clase ShortReadQ que veíamos en el ejercicio anterior (de hecho es una extensión del mismo). Podemos aplicar las mismas funciones:
length(aln)
sread(aln)
quality(aln)
head(width(aln))
Pero también tenemos funciones nuevas para accesar la información del alineamiento:
table(strand(aln))
     -      +      *
186009 208764      0
head(position(aln))

head(chromosome(aln))
[1]  82487667  76102535 107789720 134657386  24407980  67188823

[1] chr10 chr10 chr10 chr10 chr10 chr10
Levels: chr10
Y podemos accesar la información extra, que puede ser específico de cada alineador:
head(pData(alignData(aln)))
  similar mismatch
1      52    8:T>G
2     158
3       0    8:A>G
4       0    2:T>G
5       0    6:A>C
6       0   11:A>G
ShortRead nos permite crear filtros para ir eliminando elementos de nuestro objecto que no queremos. Para una descripción completa, pueden ver ?srFilter, pero por ahora vamos a usar sólo algunos. Las funciones de los filtros regresan un vector lógico que nos permite extraer los elementos que pasan, o que no pasan el filtro, según convenga.
sfilt <- strandFilter("+")

alnPos <- aln[sfilt(aln)]

table(strand(alnPos))
     -      +      *
     0 208764      0
Ese filtro simplemente nos regresa todas las secuencias que alinearon a la cadena "+".
Podemos combinar filtros y aplicarlos juntos:
cfilt <- chromosomeFilter("chr10")
sfilt <- strandFilter("+")
afilt <- alignDataFilter(expression(similar <= 10))

filts <- compose(cfilt,sfilt,afilt)

aln[filts(aln)]
class: AlignedRead
length: 199783 reads; width: 15..31 cycles
chromosome: chr10 chr10 ... chr10 chr10
position: 107789720 134657386 ... 21610942 5014830
strand: + + ... + +
alignQuality: NumericQuality
alignData varLabels: similar mismatch
En este caso obtuvimos las secuencias que alinearon al cromosoma "chr10", en la cadena "+" y que la referencia no tuviera más de 10 sitios idénticos. (El filtro especial alignDataFilter usa la información de alignData y requiere el uso de la función expression)
Vale la pena mencionar que los filtros se pueden aplicar durante la lectura de los archivos, tal que se puede evitar leer mucha información inecesaria. Por ejemplo, podríamos leer de un archivo solamente las secuencias que alinearon a uno de los cromosomas.
# aln <- readAligned(alnFile, type="Bowtie", filter=cfilt)
Una de las primeras cosas que a veces conviene hacer es explorar el alineamiento de nuestras secuencias cortas, en su contexto genómico. Para ello resulta práctico poder colocar los alineamientos en un navegador de genomas, como el de UCSC.
Tenemos un paquete en Bioconductor que nos facilita esta tarea:
library(rtracklayer)
Como primer ejercicio, generemos un archivo que podamos importar en un navegador. Pero vamos a necesitar resumir la información del alineamiento. Generalmente no nos interesan las secuencias individuales, si no las regiones donde se acumulan muchas secuencias. Para esto podemos obtener la cobertura del alineamiento:
alnCov <- coverage(aln)

alnCov
SimpleRleList of length 1
$chr10
'integer' Rle of length 135524572 with 585516 runs
  Lengths: 61393    19   124    19  2127 ...    42    15     1   625    16
  Values :     0     1     0     1     0 ...     0    28    19     0     1
Aquí estamos introduciendo objectos de clase Rle (por Run Length Encoding). Es una manera sumamente efficiente de guardar cadenas que contienen muchas corridas de elementos repetidos. En la salida anterior, podemos ver que la cobertura incluye primero 61,393 posiciones con valor 0, luego 19 posiciones con 1, 124 posiciones con 0, etc. Podemos convertir un Rle de regreso a un vector normal de números, que seguramente ocupará más memoria:
print(object.size(as.integer(alnCov$chr10)), units="Mb")

print(object.size(alnCov$chr10), units="Mb")
517 Mb

4.5 Mb
Necesitamos ahora convertir este objecto a uno en formato tabular, que nos permitirá interactuar con el navegador:
covRD <- as(alnCov,"RangedData")

covRD
RangedData with 585516 rows and 1 value column across 1 space
         space         ranges |     score
   <character>      <IRanges> | <integer>
1        chr10 [    1, 61393] |         0
2        chr10 [61394, 61412] |         1
3        chr10 [61413, 61536] |         0
4        chr10 [61537, 61555] |         1
5        chr10 [61556, 63682] |         0
6        chr10 [63683, 63698] |         1
7        chr10 [63699, 63922] |         0
8        chr10 [63923, 63938] |         1
9        chr10 [63939, 65669] |         0
10       chr10 [65670, 65693] |         1
...
<585506 more rows>
Probablemente no nos va a interesar mantener la información de todas las posiciones con cobertura 0. Podemos poner un corte inferior, quedándonos solamente con los rangos cubiertos por al menos N secuencias:
highCov <- covRD[covRD$score >= 10,]

highCov
RangedData with 12204 rows and 1 value column across 1 space
         space         ranges |     score
   <character>      <IRanges> | <integer>
1        chr10 [90038, 90038] |        19
2        chr10 [90039, 90039] |        38
3        chr10 [90040, 90055] |        46
4        chr10 [93256, 93256] |        12
5        chr10 [93257, 93257] |        26
6        chr10 [93258, 93258] |        32
7        chr10 [93259, 93259] |        59
8        chr10 [93260, 93260] |        85
9        chr10 [93261, 93261] |       115
10       chr10 [93262, 93262] |       141
...
<12194 more rows>
Podemos exportar este objecto, en un formato que puede ser leido por los navegadores genómicos. (Pueden revisar la descripción de los formatos aceptados por UCSC.)
export(highCov, "highCov.bed", format="bedGraph")
Ahora pueden importar este archivo directamente en UCSC, como un custom track. Un archivo ejemplo está disponible en esta carpeta.
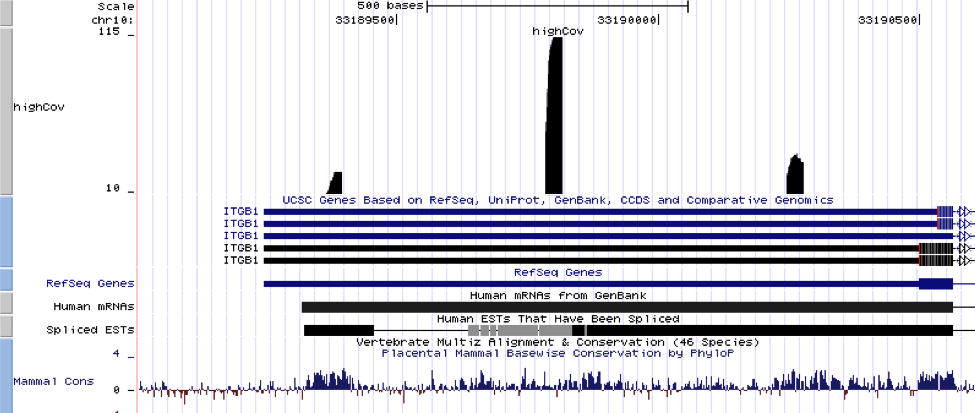
Por último, también podemos interactuar con el navegador desde dentro de R:
session <- browserSession("UCSC")

track(session, "highCov") <- highCov
Podemos elegir una región para visualizar en el navegador. En la siguiente instrucción multiplicamos el rango por -100 para hacer un zoom out por un factor de 100.
zoomRange <- range(highCov[highCov$score > 100 & width(highCov) > 15,][1,])*-100

zoomRange
CompressedIRangesList of length 1
$chr10
IRanges of length 1
       start      end width
[1] 33189009 33190608  1600
(Dependiendo de cuantos alineamientos esten incluidos en su objecto highCov, podrían tener que reducir los valores que utilicé para seleccionar una ventana con cobertura alta.)
view <- browserView(session, zoomRange, full="highCov")