En esta práctica aprenderemos a usar Bowtie para alinear secuencias cortas a un genoma. Bowtie es uno de los programas más populares para este propósito, dada su velocidad y eficiencia de memoria. Para los que esten interesados en los algoritmos usados por esta nueva generación de alineadores, les recomiendo la publicación original de Bowtie (Bowtie.pdf). Este y otros alineadores utilizan el "Burrows-Wheeler transform" para comprimir la secuencia genómica, permitiendo que hasta el genoma humano puedan ser procesado en máquinas con ~2-4 GB de RAM. La Wikipedia tiene una descripción básica de este algoritmo (Burrows-Wheeler_transform).
Otra ventaja es que existen varias herramientas que han sido desarrolladas para aprovechar su capacidad de mapeo:
Debido a que Bowtie generalmente requiere ~2-4 GB of RAM para trabajar con un genoma completo, vamos a utilizar la secuencia de un solo cromosoma para agilizar esta práctica.
Si quieren correr por su lado todos los pasos, van a necesitar bajar Bowtie de la red. Para acelerar este proceso estoy incluyendo ligas directas a la versión 0.12.7:
Eligan el archivo que corresponda a su sistema operativo, y descomprímanlo, por ejemplo a su Escritorio.
También van a necesitar descargar y descomprimir la secuencia de nuestro cromosoma de referencia chr14.fa.zip al mismo directorio.
NOTA: Bowtie corre en la línea de comando. Para abrir una en Windows, necesitan darle click en el menú de Inicio, luego en Ejecutar..., luego escriban cmd y click en OK. Luego van a necesitar entrar al directorio en donde instalaron Bowtie. Por ejemplo, si tienen una carpeta 'bowtie' en su Escritorio, la instrucción para cambiarse a ese directorio es cd Desktop\bowtie. En una Mac, necesitan abrir una Terminal (Applicaciones/Utilidades/Terminal). En la Terminal, van a necesitar cambiarse al directorio donde se encuentra bowtie: cd Desktop/bowtie.
Recuerden que vamos a necesitar al menos un archivo FASTQ y una secuencia de referencia. Asegúrense de ya haberlos bajado y descomprimido.
Bowtie tiene dos programas que vamos a usar: bowtie y bowtie-build. Con este último tendremos que pre-procesar cualquier secuencia de referencia que vayamos a usar. Para ver las opciones, simplemente ejecutamos:
bowtie-build
Usage: bowtie-build [options]* <reference_in> <ebwt_outfile_base>
    reference_in            comma-separated list of files with ref sequences
    ebwt_outfile_base       write Ebwt data to files with this dir/basename
Options:
    -f                      reference files are Fasta (default)
    -c                      reference sequences given on cmd line
    -C/--color              build a colorspace index
    -a/--noauto             disable automatic -p/--bmax/--dcv memory-fitting
    -p/--packed             use packed strings internally; slower, uses less mem
    -B                      build both letter- and colorspace indexes
    --bmax <int>            max bucket sz for blockwise suffix-array builder
    --bmaxdivn <int>        max bucket sz as divisor of ref len (default: 4)
    --dcv <int>             diff-cover period for blockwise (default: 1024)
    --nodc                  disable diff-cover (algorithm becomes quadratic)
    -r/--noref              don't build .3/.4.ebwt (packed reference) portion
    -3/--justref            just build .3/.4.ebwt (packed reference) portion
    -o/--offrate <int>      SA is sampled every 2^offRate BWT chars (default: 5)
    -t/--ftabchars <int>    # of chars consumed in initial lookup (default: 10)
    --ntoa                  convert Ns in reference to As
    --seed <int>            seed for random number generator
    -q/--quiet              verbose output (for debugging)
    -h/--help               print detailed description of tool and its options
    --usage                 print this usage message
    --version               print version information and quit
A pesar de que ahorita no vamos a usar estas opciones, vale la pena notar que Bowtie permite preparar una referencia para ser procesado en el colorspace de ABI SOLiD.
Si llegan a necesitar que bowtie localice secuencias altamente repetidas en un genoma, con mayor velocidad, pero usando más memoria, pueden decrementar el parámetro --offrate a 3 o 2.
Finalmente, como no tenemos datos de secuenciación de extremos apareados, podemos ahorrar espacio en disco utilizando la opción --noref.
Preparemos entonces nuestra secuencia de referencia:
bowtie-build --noref chr14.fa chr14
Settings:
  Output files: "chr14.*.ebwt"
  Line rate: 6 (line is 64 bytes)
  Lines per side: 1 (side is 64 bytes)
  Offset rate: 5 (one in 32)
  FTable chars: 10
  Strings: unpacked

...

    numSides: 394150
    numLines: 394150
    ebwtTotLen: 25225600
    ebwtTotSz: 25225600
    reverse: 0
Total time for backward call to driver() for mirror index: 00:01:08
Esto puede tardar varios minutos, dependiendo de su computadora. Para agilizar esto, pueden bajar directamente los archivos que serían generados por la última instrucción: chr14.ebwt.zip
Cuando tengamos los archivos del índice, usamos bowtie para realizar el mapeo. Existen muchas opciones para especificar cómo queremos que Bowtie haga el alineamiento y cuáles resultados queremos guardar. Pueden escribir bowtie para ver una descripción breve sobre todas las opciones. Para una descripción más completa, pueden ver el manual. Aquí les muestro algunas de las opciones más importantes:
bowtie
Usage:
  bowtie [options]* <ebwt> {... <s>} [<hit>]
  <hit>   File to write hits to (default: stdout)
  <s>     Comma-separated list of files containing unpaired reads, or the
          sequences themselves, if -c is set.  Specify "-" for stdin.

Input:
  -q                 query input files are FASTQ .fq/.fastq (default)
  -f                 query input files are (multi-)FASTA .fa/.mfa
  -C                 reads and index are in colorspace
  -5/--trim5 <int>   trim <int> bases from 5' (left) end of reads
  -3/--trim3 <int>   trim <int> bases from 3' (right) end of reads
  --phred64-quals    input quals are Phred+64 (same as --solexa1.3-quals)

Alignment:
  -v <int>           report end-to-end hits w/ <=v mismatches; ignore qualities
    or
  -n/--seedmms <int> max mismatches in seed (can be 0-3, default: -n 2)
  -m <int>           suppress all alignments if > <int> exist (def: no limit)
  --nofw/--norc      do not align to forward/reverse-complement reference strand

Reporting:
  -k <int>           report up to <int> good alignments per read (default: 1)
  -a/--all           report all alignments per read (much slower than low -k)
  --best             hits guaranteed best stratum; ties broken by quality

Output:
  -t/--time          print wall-clock time taken by search phases
  --al <fname>       write aligned reads/pairs to file(s) <fname>
  --un <fname>       write unaligned reads/pairs to file(s) <fname>
  --suppress <cols>  suppresses given columns (comma-delim'ed) in default output

SAM:
  -S/--sam           write hits in SAM format

Performance:
  -p/--threads <int> number of alignment threads to launch (default: 1)
Si no tienen el archivo clean_reads.fq, bájenlo aquí: clean_reads.fq.zip. Van a necesitar descomprimir este archivo al mismo directorio donde tienen a bowtie.
El siguiente comando va a mapear todas las secuencias contenidas en clean_reads.fq sobre el índice chr14 y a guardar los resultados en clean_reads.bwt. Los otros parámetros especifican que estamos usando valores de calidad que se encuentran recorridos por 64 (--phred64-quals), que queremos solo alineamientos de la lectura completa con 0 mismatches (-v 0) y que reporte solo alineamientos con una posición única en el genoma (-m 1).
bowtie --phred64-quals -v 0 -m 1 chr14 clean_reads.fq clean_reads.bwt
# reads processed: 484342
# reads with at least one reported alignment: 393848 (81.32%)
# reads that failed to align: 44298 (9.15%)
# reads with alignments suppressed due to -m: 46196 (9.54%)
Reported 393848 alignments to 1 output stream(s)
Veamos como se ve la salida de bowtie:
more clean_reads.bwt
GAII06_0003:3:1:1040   +   chr14   74190112   CCAAAGTGCT..GAATTATT   CC@@;CC???;@..?:=ACA=A-=:9   0
GAII06_0003:3:1:1148   +   chr14   53512944   TAAATACAGT..AAACAAGT   D=5?A@6=C.B@..5CCCAADB=BDC   0
GAII06_0003:3:1:1228   -   chr14   53119249   AATAATACAT..AAAATGTG   DFDCFDBFFF?C..EB=FFFFF?FED   0
Las columnas son:
Si no terminan esta parte, pueden bajar el resultado del alineamiento para continuar con la siguiente sección: clean_reads.bwt.zip
Primero necesitamos cargar los paquetes que vamos a usar:
library(ShortRead)
library(rtracklayer)
Para poder leer el archivo, necesitamos moverlo a nuestro directorio de trabajo. Luego podemos leer los resultados de mapeo:
alnFile = "clean_reads.bwt"

aln = readAligned(alnFile, type="Bowtie")

aln
class: AlignedRead
length: 392963 reads; width: 51 cycles
chromosome: chr14 chr14 ... chr14 chr14
position: 74190113 53512945 ... 105477651 23536730
strand: + + ... - +
alignQuality: NumericQuality
alignData varLabels: similar mismatch
Podemos obtener información del objeto generado:
sread(aln)

head(chromosome(aln))

table(strand(aln))
Podemos usar esta información para elegir solo las lecturas que mapean a un cromosoma en particular o a una cadena. También podemos filtrar las lecturas del mismo modo en que filtrabamos los datos del archivo fastq.
Una manera muy útil para visualizar los resultados en un navegador de genomas, es obtener la cobertura en cada posición del cromosoma. Esto es sencillamente la profundiad o número de lecturas que caen sobre cada posición.
alnCov = as(coverage(aln),"RangedData")

alnCov
RangedData with 615756 rows and 1 value column across 1 space
         space               ranges |     score
   <character>            <IRanges> | <integer>
1        chr14 [       1, 19003751] |         0
2        chr14 [19003752, 19003802] |         1
3        chr14 [19003803, 19012208] |         0
4        chr14 [19012209, 19012259] |         1
5        chr14 [19012260, 19013724] |         0
...
<615746 more rows>
Las posiciones que fueron secuenciadas muy pocas veces, probablemente tienen mucho ruido. Podemos excluir todas las posiciones que no tienen al menos cierto valor de cobertura:
highCov = alnCov[alnCov$score >= 5,]

highCov
RangedData with 331478 rows and 1 value column across 1 space
         space               ranges |     score
   <character>            <IRanges> | <integer>
1        chr14 [19410922, 19410923] |         5
2        chr14 [19410924, 19410927] |         7
3        chr14 [19410928, 19410929] |         8
4        chr14 [19410930, 19410930] |         9
5        chr14 [19410931, 19410934] |        10
...
<331468 more rows>
Finalmente, podemos exportar esta información a un track que puede ser importado por la mayoría de los navegadores de genomas, para visualizar los resultados. (Pueden revisar la descripción de los formatos aceptados por UCSC.)
export(highCov, "highCov.bed", format="bedGraph")
Si no pudieron terminar esta parte, pueden bajar el archivo de aquí highCov.bed.gz (pero no lo descompriman).
Entren al genome browser, y carguen este archivo como un custom track. Asegúrense de que tienen elegido el genoma humano (clade = Mammal, genome = Human, assembly = Feb.2009). Click en add custom tracks, luego Browse... para seleccionar su archivo, luego Submit.
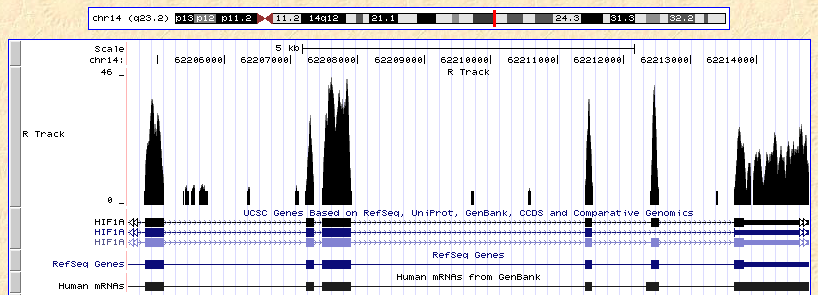
Ahora pueden regresar al navegador, y buscar el gen HIF1A como un ejemplo. Pueden configurar cómo se despliegan los resultados de RNA-Seq dando click en la izquierda del R Track.
Esperamos que resultados de RNA-Seq contengan principalmente secuencias de exones, pero sí vamos a encontrar algunos casos de lecturas mapeando a intrones o regiones intergénicas.