En esta sesión vamos a analizar datos que se produjeron en el Illumina Genome Analyzer IIx. Este aparato produce 8 carriles de secuencias por corrida, cada una con unas 40 millones de lecturas cortas. Para secuenciar RNA pequeño (de 20-30 bases) lecturas de 37 bases son suficientes. Para otras aplicaciones como secuenciación de genomas o transcriptomas, conviene obtener lecturas más largas, las cuales pueden ser de hasta 150 bases.
Como se pueden imaginar, la cantidad tan grande de datos generados por un secuenciador a veces requiere de computadoras con mucha memoria. Sin embargo, en general se puede partir el problema en fracciones más pequeñas que se pueden manejar en computadoras personales. Para este ejercicio, usaremos parte de un experimento de sRNA-Seq, consistiendo de 250 mil lecturas de 37 bases.
El archivo que contiene las lecturas puede ser bajado de aquí: human_sRNA_250k.fq.zip. Por favor descárguenlo y extraigan el contenido en su directorio de trabajo.
Se necesita lo siguiente para realizar esta práctica
| R | Instalado |
| Bioconductor | Instalado |
| ShortRead | Instalado |
La mayoría de los resultados de secuenciadores se pueden obtener en un formato llamado fastq. En realidad es un formato de texto, muy similar al formato fasta que seguro ya conocen. La "q" se refiere a "quality" e implica que cada posición, ademas de tener una letra, tiene asociado un valor de calidad.
La confianza con la que se predice una base en una posición, puede resumirse con un valor numérico de calidad. La calificación Phred se encuentra asociada logaritmicamente a la probalidad de error, como se muestra en la siguiente tabla:
| Calificación Phred de calidad | Probabilidad de que la base sea incorrecta | Precisión de la base |
|---|---|---|
| 10 | 1 en 10 | 90 % |
| 20 | 1 en 100 | 99 % |
| 30 | 1 en 1000 | 99.9 % |
| 40 | 1 en 10000 | 99.99 % |
Regresando a nuestro archivo fastq, los primeros renglones se ven así:
@IL21_4392:7:1:1487:3943/1
AATTGCATCTCGTATGCCGTCTTCTGNTTGAANNNNA
+
GFGEACFF=F@<FBEGA;FGFF38FB)C@E88&&&&1
El primer renglón es el identificador (comenzando por @), después del cual viene la secuencia. El renglón que comienza con + suele contener otra vez el mismo identificador, aunque se puede omitir para ahorrar espacio de disco. Al final viene una serie de caracteres que representan la calidad, un caracter por cada letra de la secuencia.
Para que la cadena de valores de calidad tenga la misma longitud que la secuencia, se codifica el número convirtiéndolo en un caracter ascii. Para evitar caracteres ascii que no se pueden desplegar en pantalla, se suele agregar 33 al número de calidad antes de codificarlo. Pueden revisar la tabla ascii (Decimal) que se muestra a continuación:
       0 nul    1 soh    2 stx    3 etx    4 eot    5 enq    6 ack    7 bel
       8 bs     9 ht    10 nl    11 vt    12 np    13 cr    14 so    15 si
      16 dle   17 dc1   18 dc2   19 dc3   20 dc4   21 nak   22 syn   23 etb
      24 can   25 em    26 sub   27 esc   28 fs    29 gs    30 rs    31 us
      32 sp    33  !    34  "    35  #    36  $    37  %    38  &   39  '
      40  (    41  )    42  *    43  +    44  ,    45  -    46  .    47  /
      48  0    49  1    50  2    51  3    52  4    53  5    54  6    55  7
      56  8    57  9    58  :    59  ;    60  <    61  =    62  >    63  ?
      64  @    65  A    66  B    67  C    68  D    69  E    70  F    71  G
      72  H    73  I    74  J    75  K    76  L    77  M    78  N    79  O
      80  P    81  Q    82  R    83  S    84  T    85  U    86  V    87  W
      88  X    89  Y    90  Z    91  [    92  \    93  ]    94  ^    95  _
      96  `    97  a    98  b    99  c   100  d   101  e   102  f   103  g
     104  h   105  i   106  j   107  k   108  l   109  m   110  n   111  o
     112  p   113  q   114  r   115  s   116  t   117  u   118  v   119  w
     120  x   121  y   122  z
R
library(ShortRead)
Tenemos que cambiarnos al directorio de trabajo, donde tenemos guardado el archivo fastq que vamos a leer. Para asegurarnos de estar en el lugar correcto, vale la pena hacer algo así:
getwd()

list.files()
Vale la pena recordar que dentro de R podemos hacer cualquier llamado al sistema, para ejecutar comandos como los que acabamos de hacer.
system("head -n 4 human_sRNA_250k.fq")
@IL21_4392:7:1:1487:3943/1
AATTGCATCTCGTATGCCGTCTTCTGNTTGAANNNNA
+
GFGEACFF=F@<FBEGA;FGFF38FB)C@E88&&&&1
Para empezar a trabajar con ShortRead, definamos una variable para el nombre del archivo a leer.
fastqFile = "human_sRNA_250k.fq"
El comando para leer archivos en formato fastq es readFastq. Se puede utilizar para leer multiples archivos en un directorio, contatenando el resultado. Pero por ahora solo vamos a leer un archivo.
solexa = readFastq(fastqFile)
solexa
class: ShortReadQ
length: 250000 reads; width: 37 cycles
Funciones para accesar las características básicas del objeto:
length(solexa)
[1] 250000
table(width(solexa))
    37
250000
Podemos accesar los identificadores de las secuencias:
id(solexa)
  A BStringSet instance of length 250000
         width seq
     [1]    25 IL21_4392:7:1:1487:3943/1
     [2]    25 IL21_4392:7:1:1488:5467/1
     ...   ... ...
[249999]    27 IL21_4392:7:2:12847:10308/1
[250000]    26 IL21_4392:7:2:12847:9469/1
las secuencias:
sread(solexa)
  A DNAStringSet instance of length 250000
         width seq
     [1]    37 AATTGCATCTCGTATGCCGTCTTCTGNTTGAANNNNA
     [2]    37 AACAGCCAGCATCTCGTATGCCGTCTNCTGCCNNNAA
     ...   ... ...
[249999]    37 ACGTTCAAACCGTTACCATTACTGAGTATCTCGTATG
[250000]    37 ATCTACTGAGGTAGTAGATTGTATAGTTAATCTCGTA
las calidades:
quality(solexa)
class: FastqQuality
quality:
  A BStringSet instance of length 250000
         width seq
     [1]    37 GFGEACFF=F@<FBEGA;FGFF38FB)C@E88&&&&1
     [2]    37 H5?E7F3@HF3HEC-7H7GB/H@H=E&@<D+(&&&88
     ...   ... ...
[249999]    37 HEEG:HH>HGGEEHHHIGIFAGHB;G5HGGB=E@HGG
[250000]    37 IIIFHFIIEIIAFIIIIDIIIAEGGICGFGGHGGGHG
o las tres cosas con un sólo comando:
detail(solexa)y como buen objeto de R, podemos aplicar cualquiera de las funciones sobre solamente una parte:
sread(solexa[101:103])
  A DNAStringSet instance of length 3
    width seq
[1]    37 AGCGACTGAGATGAAGCACTGTAGCTCATATCTCGTA
[2]    37 AGGTGCATCTCGTATGCCGTCTTCTGCTTGAAAAAAA
[3]    37 ACACGCATCTCGTATGACGTCTTCTGCTTGAAAAAAA
Es de esperarse que conforme avancen los ciclos de secuenciación el resultado puede ir empeorando. De hecho, esta es una de las razones por la que no se pueden usar estos aparatos para obtener secuencias demasiado largas.
Podemos revisar la frecuencia de nucleótidos conforme avanza la secuencia. Desviaciones grandes podrían implicar un problema técnico, o se pueden deber a alguna propiedad del protocolo que se utilizó para preparar el material a secuenciar.
abc = alphabetByCycle(sread(solexa), alphabet=c("A","T","G","C","N"))
abc
        cycle
alphabet   [,1]  [,2]   [,3]  [,4]   [,5]   [,6]  [,7]  [,8]  [,9]  [,10]
       A 237412 78730  46200 70054  78575   5695 92331 49013 79389  38548
       T   5570 34098  37748 81658 104102  10562 83141 90808 25068 100590
       G   3620 78532  62911 57030  56133   4301 25806 81598 50317  72686
       C   1707 58640 103141 41258  11190 229442 48722 28581 95226  38176
       N   1691     0      0     0      0      0     0     0     0      0
Para convertirlo a frecuencias podemos dividir por el número de secuencias:
abcFreq = abc / length(solexa)
abcFreq
        cycle
alphabet     [,1]     [,2]     [,3]     [,4]     [,5]     [,6]     [,7]
       A 0.949648 0.314920 0.184800 0.280216 0.314300 0.022780 0.369324
       T 0.022280 0.136392 0.150992 0.326632 0.416408 0.042248 0.332564
       G 0.014480 0.314128 0.251644 0.228120 0.224532 0.017204 0.103224
       C 0.006828 0.234560 0.412564 0.165032 0.044760 0.917768 0.194888
       N 0.006764 0.000000 0.000000 0.000000 0.000000 0.000000 0.000000
Pero es mucho más fácil analizar esto en una figura:
Primero definamos una serie de colores, uno para cada base (y uno extra para las N). También necesitamos saber los ciclos que vamos a analizar, para usar como etiquetas.
cols = rainbow(5)

cycles = 1:max(width(solexa))
Ahora podemos producir una figura con la frecuencia de las bases.
barplot(abcFreq, ylim=c(0,1.1), col=cols, beside=FALSE, space=0, names.arg=cycles, las=3,
     xlab="cycle", ylab="Frequency", main="Base frequency by Cycle")

legend("top",legend=rownames(abcFreq), fill=cols, bty="n", horiz=TRUE)
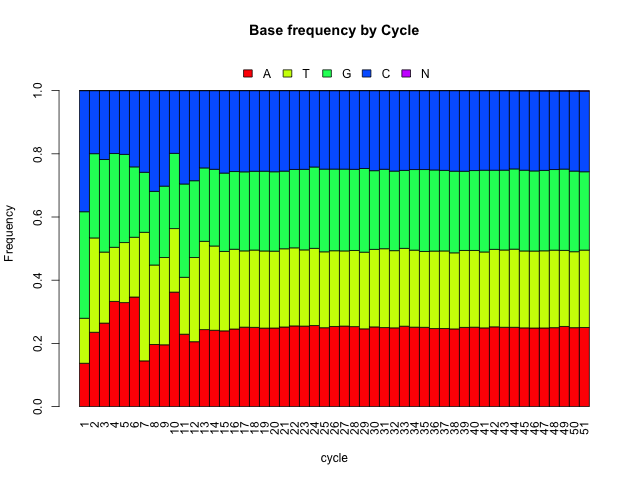
Notan las fluctuaciones en la composición? Se ve exagerada la frecuencia en las posiciones 1 y 6.
Resulta que este experimento estaba utilizando un barcode en el extremo 5' del inserto, para al final poder identificar de qué individuo provenía cada secuencia. Utilizaron barcodes de 6 bases, que empezaban con A y que terminaba con C, para evitar tener sesgos en el paso de la ligación.
Hay una función que nos permite recortar todas las lecturas por una cantidad constante, que es lo que requerimos en este caso.
solexa = narrow(solexa, start=7)
solexa
class: ShortReadQ
length: 250000 reads; width: 31 cycles
Pueden repetir el análisis de frecuencia para asegurarse que hemos eliminado el problema.
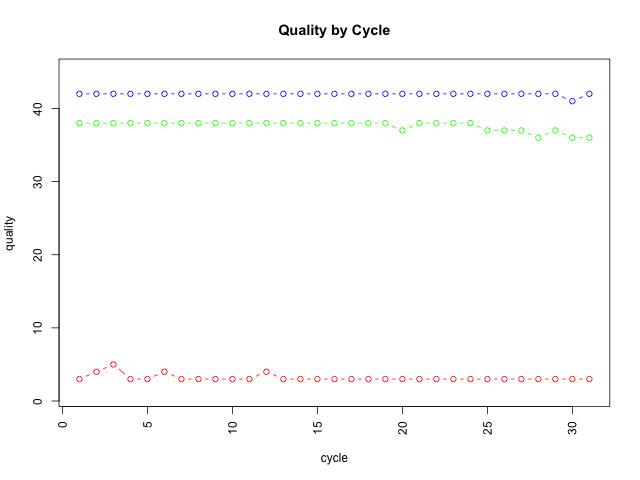
Por otro lado, la calificación de calidad de cada base también nos habla de la confianza con la que podemos tener en la identidad de esa base en particular. La calidad puede disminuir conforme avanzan los ciclos, pero debemos revisar que no baje demasiado.
Para convertir rápidamente las calidades codificadas a su valor numérico, podemos aprovechar que R internamente puede convertir los caracteres a valores numéricos:
as(quality(solexa[1]), "numeric")
[1] 37 37 28 37 31 27 37 33 36 38 32 26 37 38 37 37 18 23 37 33 8 34 31 36 23 23 5 5 5 5 16
Si queremos convertir las calificaciones de calidad de todas las secuencias a la vez, manteniendo las que vienen de secuencias diferentes como series de números diferentes, podemos convertir directamente a una matriz:
numQuals = as(quality(solexa), "matrix")

head(numQuals)
     [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9] [,10] [,11] [,12] [,13] [,14]
[1,]   37   37   28   37   31   27   37   33   36    38    32    26    37    38
[2,]   18   31   39   37   18   39   36   34   12    22    39    22    38    33
[3,]   33   39   36   38   30   38   39   31   39    36    38    38    39    39
...
Y una vez más, queremos visualizar estos valores, resumiéndolos de alguna manera. Por ejemplo, podemos calcular el máximo, mínimo y mediana de los valores de calidad en cada ciclo:
maxQ  = apply(numQuals,2,max)
minQ  = apply(numQuals,2,min)
medQ  = apply(numQuals,2,median)

maxQ
minQ
 [1] 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 42 ...

 [1] 3 4 5 3 3 4 3 3 3 3 3 4 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
Ahora podemos hacer una figura:
plot(seq_along(minQ), minQ, type="b", col="red", main="Quality by Cycle", las=3, ylim=c(1,45),
        xlab="cycle", ylab="quality")
lines(cycles, medQ, type="b", col="green")
lines(cycles, maxQ, type="b", col="blue")
Ejercicios:
Es muy importante recordar que cuando secuenciamos RNA pequeño, el inserto esperado mide menos que la lectura del secuenciador. Si no eliminamos correctamente la contaminación del adaptador, podemos tener muchos problemas para analizar correctamente los datos.
Podemos usar la función srdistance para encontrar la distancia entre todas las secuencias y una en particular, en este caso la del adaptador:
linker = "ATCTCGTATGCCGTCTTCTGCTTG"

dists = srdistance(solexa, linker)
Revisen la ayuda de la función para entender lo que esta haciendo. Podemos hacer un histograma para ver la distribución de las distancias de todas nuestras secuencias al adaptador.
hist(dists[[1]], col="skyblue", main=linker)
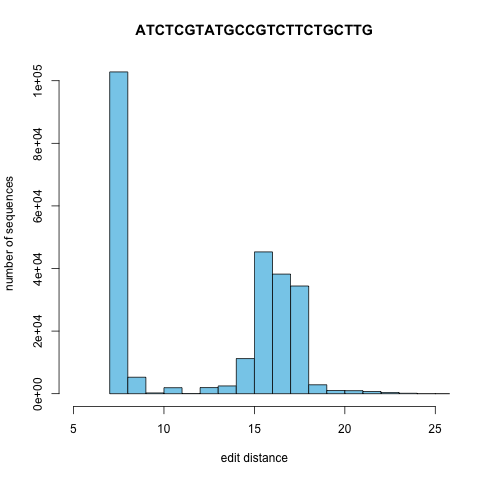
Esto significa que sí hay una porción importante de secuencias que contienen el adaptador, puesto que la distancia mínima que podemos obtener es de 7, que son los cambios necesarios (i.e. quitar letras) para convertir una de nuestras secuencias de 31 bases en nuestro adaptador de 24. Podemos observarlo directamente:
sread(solexa)[dists[[1]] == 7]
  A DNAStringSet instance of length 99827
        width seq
    [1]    31 GACATCTCGTATGCCGTCTTCTGCTTGAAAA
    [2]    31 ATCTCGTATGCCGTCTTCTGCTTGAAAAAAA
    [3]    31 ATCTCGTATGCCGTCTTCTGCTTGAAAAAAA
     ...   ... ...
Existe una función diseñada precisamente para buscar patrones y eliminar las partes de las secuencias que la contengan.
?trimLRPatterns
En principio sólo especificamos una secuencia a quitar, y el lado del cual queremos buscarlo. Sin embargo, hemos visto que nuestro adaptador puede estar contenido hacia el centro de las secuencias. Por ello, nos conviene preparar un adaptador modificado, que contenga las primeras bases del adaptador (las que constantemente aparecen juntas en la secuencia) seguida de una cola de N que permitirá aceptar la variabilidad que estamos observando.
linkerMod = paste(substr(linker,1,12),"NNNNNNNNNNNNNNNNNNN",sep="")
linkerMod
[1] "ATCTCGTATGCCNNNNNNNNNNNNNNNNNNN"
La función también permite especificar el número de mismatches que se tolerarán en cada parte de nuestro adaptador. Para permitir un 15% de mismatches, pero solamente en la parte informativa del adaptador, podemos construir un vector:
maxRmm = round(seq_len(12)*0.15)
maxRmm = c(maxRmm, rep(max(maxRmm),nchar(linkerMod)-12))
maxRmm
[1] 0 0 0 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2
Ahora si, podemos eliminar el adaptador de todas nuestras secuencias, recortándolas desde el lado derecho.
solexaTrim  = trimLRPatterns(Lpattern = "", Rpattern = linkerMod, solexa,
                  with.Rindels=FALSE, max.Rmismatch=maxRmm, Rfixed=FALSE)

sread(solexaTrim)[dists[[1]] == 7]
  A DNAStringSet instance of length 99827
        width seq
    [1]     3 GAC
    [2]     0
    [3]     0
    ...   ... ...
[99825]     3 GGA
[99826]     5 CTTTG
[99827]     0
Parece haber quitado correctamente la contaminación del adaptador.
Para visualizar el resultado completo, podemos hacer otro histograma, ahora con las longitudes de todos los fragmentos resultantes:
hist(width(solexaTrim), col="skyblue", breaks=0:31)
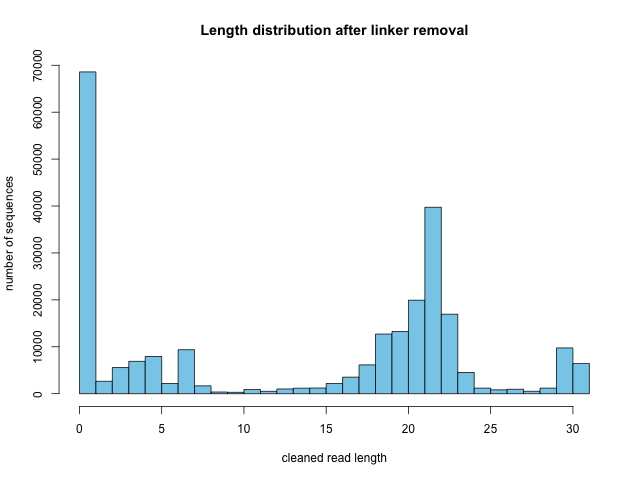
Ahora si podemos apreciar la distribución de las moléculas que queríamos secuenciar. Los microRNAs tienen una longitud promedio de 21 bases, que es precisamente el pico que vemos. Los fragmentos muy cortos son contaminación, y los que son muy largos son fragmentos de moléculas más largas que no queremos considerar.
Podemos restringir los datos a un rango de longitudes aceptables:
solexaTrim = solexaTrim[width(solexaTrim) > 14 & width(solexaTrim) < 28]
solexaTrim
class: ShortReadQ
length: 123040 reads; width: 15..27 cycles
En muchas aplicaciones, queremos quitar las lecturas que recurren muchas veces con una secuencia idéntica. Estos pueden aparecer por culpa de la amplificación durante la construcción de la biblioteca. Esto es particularmente importante para experimentos de tipo RNA-Seq y ChIP-Seq. Para experimentos de sRNA-Seq, donde esperamos poder secuenciar muchas veces el mismo microRNA, eliminar las secuencias duplicadas arruinaría el experimento. Sin embargo, hagámos un paréntesis y veamos cómo se realizaría este paso dentro de R.
Para quitar todos excepto la primera copia de las lecturas duplicadas, podemos hacer esto:
solexaUnique = solexaTrim[!srduplicated(solexaTrim)]

solexaUnique
class: ShortReadQ
length: 14875 reads; width: 15..27 cycles
Otra cosa que conviene revisar, es si tenemos muchas lecturas compuestas principalmente por una base. Es poco probable que estas vayan a ser de utilidad, y pueden surgir por problemas técnicos del secuenciador, o por la clonación de fragmentos de colas poliadeniladas.
Una manera de visualizar las secuencias para averiguar si tenemos este problema, es ordenarlas alfabéticamente:
srsort(sread(solexaTrim))
  A DNAStringSet instance of length 123040
         width seq
     [1]    15 AAAAAAAAAAAAAAA
     [2]    21 AAAAAAGCTTGGAACTCCATC
     [3]    16 AAAAATTTCGGTGGGG
     ...   ... ...
[123038]    22 TTTTTCATTATTGCTCCTGACC
[123039]    23 TTTTTCATTATTGCTCCTGACCA
[123040]    22 TTTTTCATTATTGCTCCTGCCC
Tenemos una serie de funciones para filtrar secuencias indeseadas. Podemos configurar un filtro para quedarnos solamente con lecturas que no tengan más de 14 bases idénticas. Tambien podemos generar un filtro para que pasen solo lecturas que tengan 0 bases ambiguas, N:
pfilt = polynFilter(threshold=20)

nfilt = nFilter(threshold=0)
Ahora tenemos que aplicar estos filtros para quedarnos solamente con las lecturas que satisfacen las restricciones:
solexaClean = solexaTrim[pfilt(solexaTrim)]

length(solexaClean)

solexaClean = solexaClean[nfilt(solexaClean)]

length(solexaClean)
[1] 122989

[1] 122986
Finalmente, podemos guardar un nuevo archivo fastq con todas las lecturas buenas:
writeFastq(solexaClean, "clean_reads.fq")
Ejercicios:
Los archivos que salen de una corrida completa de secuenciació pueden ser enormes y rápidamente nos podemos quedar sin memoria si queremos procesarlos completos. Tenemos un par de funciones para facilitar la exploración de estos archivos, que describiremos a continuación.
En primer lugar, podemos extraer una muestra aleatoria de un archivo Fastq, sin necesidad de cargar el archivo completo a memoria:
sampler = FastqSampler(fastqFile, n=1000)

fqSample  = yield(sampler)

close(sampler)
Podemos tomar cuantas muestras independientes querramos, antes de cerrar la conexión. Luego podemos trabajar con estos objetos como hemos venido haciendo:
fqSample

sread(fqSample)
class: ShortReadQ
length: 1000 reads; width: 37 cycles

  A DNAStringSet instance of length 1000
       width seq
   [1]    37 AACGTCGGGGATGTAGTTCATCTCGTATGCCGTCTTC
   [2]    37 AACAGCACAGCATCTCGTATGCCGTCTTCTGCTTGAA
   [3]    37 AACAGCTGAGATGAAGCACTGTAGCTCTATCTCGTAT
   ...   ... ...
 [998]    37 AACGTCTGAGATGAAGCACTGTAGCTATCTCGTATGC
 [999]    37 AACGTCATCTCGTATGCCGTCTTCTGCTTGAAAAAAA
[1000]    37 ACGTTCGTATGCCGTCTTCTGCTTGAAAAAAAAAACC
En segundo lugar, podemos ir recorriendo el archivo completo, avanzando muestra por muestra, mediante la función fastqStreamer y operando sobre cada muestra dentro de un ciclo:
streamer = FastqStreamer(fastqFile, n=10000)

while (length({fqSample = yield(streamer)})) {
   # Hacer algo con la muestra
   print(fqSample)
}

close(streamer)
class: ShortReadQ
length: 10000 reads; width: 37 cycles
class: ShortReadQ
length: 10000 reads; width: 37 cycles
class: ShortReadQ
length: 10000 reads; width: 37 cycles
...
Ejercicio Final:
Como habrán visto en este práctica, R y Bioconductor ofrecen un ambiente muy poderoso para hacer un análisis completo y muy flexible, pudiendo observar directamente el resultado de cada uno de los pasos. Esto es ideal cuando estamos desarrollando una nueva aplicación, o cuando estamos aprendiendo a interpretar un conjunto nuevo de datos. Sin embargo, para una situación de producción, donde sabemos exactamente los pasos que queremos ejecutar, y nos importa que sea lo más eficiente y rápido posible, R puede no ser lo más apropiado.
Algunas de las aplicaciones especializadas en el tipo de analisis que acabamos de hacer son: