En esta sesión vamos a analizar datos que se produjeron en el Illumina Genome Analyzer IIx. Este aparato produce 8 carriles de secuencias por corrida, cada una con unos 40 millones de lecturas cortas. Para secuenciar RNA pequeño (de 20-30 bases) lecturas de 37 bases son suficientes. Para otras aplicaciones como secuenciación de genomas o transcriptomas, conviene mucho obtener lecturas más largas, las cuales pueden ser de hasta 150 bases.
Como se pueden imaginar, la cantidad tan grande de datos generados por un secuenciador a veces requiere de computadoras con mucha memoria. Sin embargo, en general se puede partir el problema en fracciones más pequeñas que se pueden manejar en computadoras personales. Para este ejercicio, usaremos parte de un experimento de RNA-Seq, consistiendo de más de 820 mil lecturas de 51 bases.
El archivo que contiene las lecturas puede ser bajado de aquí: solexa.chr14.fq.zip. Por favor descárguenlo y extraigan el contenido en su directorio de trabajo.
Si tienen acceso a menos de 1GB de memoria, mejor usen este archivo: small_solexa.chr14.fq.zip
La mayoría de los resultados de secuenciadores se pueden obtener en un formato llamado fastq. En realidad es un formato de texto, muy similar al formato fasta que seguro ya conocen. La "q" se refiere a "quality" e implica que cada posición, ademas de tener una letra, tiene asociado un valor de calidad.
La confianza con la que se predice una base en una posición, puede resumirse con un valor numérico de calidad. La calificación Phred se encuentra asociada logaritmicamente a la probalidad de error, como se muestra en la siguiente tabla:
| Calificación Phred de calidad | Probabilidad de que la base sea incorrecta | Precisión de la base |
|---|---|---|
| 10 | 1 en 10 | 90 % |
| 20 | 1 en 100 | 99 % |
| 30 | 1 en 1000 | 99.9 % |
| 40 | 1 en 10000 | 99.99 % |
Regresando a nuestro archivo fastq, los primeros renglones se ven así:
@GAII06_0003:3:1:1040:19544#0/1
CCAAAGTGCTGGAATCACAGGCGTGAGCTACCTCGCCTGGCCTGAATTATT
+
bb__Zbb^^^]Z_]]aT]`^TbbYb^_`T_cc`aac^Y\`b`\`L]_]\YX
El primer renglón es el identificador (comenzando por @), después del cual viene la secuencia. El renglón que comienza con + suele contener otra vez el mismo identificador, aunque se puede omitir para ahorrar espacio de disco. Al final viene una serie de caracteres que representan la calidad, un caracter por cada letra de la secuencia.
Para que la cadena de valores de calidad tenga la misma longitud que la secuencia, se codifica el número convirtiéndolo en un caracter ascii. Para evitar caracteres ascii que no se pueden desplegar en pantalla, se suele agregar 33 (o en este caso 64) al número de calidad antes de codificarlo. Pueden revisar la tabla ascii (Decimal) que se muestra a continuación:
       0 nul    1 soh    2 stx    3 etx    4 eot    5 enq    6 ack    7 bel
       8 bs     9 ht    10 nl    11 vt    12 np    13 cr    14 so    15 si
      16 dle   17 dc1   18 dc2   19 dc3   20 dc4   21 nak   22 syn   23 etb
      24 can   25 em    26 sub   27 esc   28 fs    29 gs    30 rs    31 us
      32 sp    33  !    34  "    35  #    36  $    37  %    38  &    39  '
      40  (    41  )    42  *    43  +    44  ,    45  -    46  .    47  /
      48  0    49  1    50  2    51  3    52  4    53  5    54  6    55  7
      56  8    57  9    58  :    59  ;    60  <    61  =    62  >    63  ?
      64  @    65  A    66  B    67  C    68  D    69  E    70  F    71  G
      72  H    73  I    74  J    75  K    76  L    77  M    78  N    79  O
      80  P    81  Q    82  R    83  S    84  T    85  U    86  V    87  W
      88  X    89  Y    90  Z    91  [    92  \    93  ]    94  ^    95  _
      96  `    97  a    98  b    99  c   100  d   101  e   102  f   103  g
     104  h   105  i   106  j   107  k   108  l   109  m   110  n   111  o
     112  p   113  q   114  r   115  s   116  t   117  u   118  v   119  w
     120  x   121  y   122  z
R
library(ShortRead)
Tenemos que cambiarnos al directorio de trabajo, donde tenemos guardado el archivo fastq que vamos a leer. Para asegurarnos de estar en el lugar correcto, vale la pena hacer algo así:
getwd()

list.files()
Vale la pena recordar que dentro de R podemos hacer cualquier llamado al sistema, para ejecutar comandos como los que acabamos de hacer.
system("head -n 4 solexa.chr14.fq")
@GAII06_0003:3:1:1040:19544#0/1
CCAAAGTGCTGGAATCACAGGCGTGAGCTACCTCGCCTGGCCTGAATTATT
+
bb__Zbb^^^]Z_]]aT]`^TbbYb^_`T_cc`aac^Y\`b`\`L]_]\YX
Para empezar a trabajar con ShortRead, definamos una variable para el nombre del archivo a leer.
fastqFile = "solexa.chr14.fq"
El comando para leer archivos en formato fastq es readFastq. Se puede utilizar para leer multiples archivos en un directorio, contatenando el resultado. Pero por ahora solo vamos a leer un archivo.
solexa = readFastq(fastqFile)
solexa
class: ShortReadQ
length: 820522 reads; width: 51 cycles
Funciones para accesar las características básicas del objeto:
length(solexa)
[1] 820522
head(width(solexa))
[1] 51 51 51 51 51 51Podemos accesar los identificadores de las secuencias:
id(solexa)
  A BStringSet instance of length 820522
         width seq
     [1]    30 GAII06_0003:3:1:1040:19544#0/1
     [2]    29 GAII06_0003:3:1:1148:2517#0/1
     ...   ... ...
[820521]    32 GAII06_0003:3:120:19833:6886#0/1
[820522]    33 GAII06_0003:3:120:19834:10439#0/1
las secuencias:
sread(solexa)
  A DNAStringSet instance of length 820522
         width seq
     [1]    51 CCAAAGTGCTGGAATCACAGGCGTGAGCTACCTCGCCTGGCCTGAATTATT
     [2]    51 TAAATACAGTAGTTCAAATATTGTTTTAAGCATTAGTTTTTCTAAACAAGT
     ...   ... ...
[820521]    51 CAAATTGGCAAAGTAGTCCAGGTTTACAGGAAGAAATATGTTANNNANNNN
[820522]    51 CTTCCAGAAAAATCTCAAGGAAAAGTATTGCAAGCAACAGTAGNNNNNNNN
las calidades:
quality(solexa)
  A BStringSet instance of length 820522
         width seq
     [1]    51 bb__Zbb^^^]Z_]]aT]`^TbbYb^_`T_cc`aac^Y\`b`\`L]_]\YX
     [2]    51 c\T^`_U\bUMa_a_ac`acc^cccbW_TcY_cb^bTbbb``__cca\acb
     ...   ... ...
[820521]    51 effffcfffceaededbdddfffffffffffffefffcecY]`BBBBBBBB
[820522]    51 efffdfff^f^]`ccfddfcadd`dceeeeeddeeeecee[Z`BBBBBBBB
o las tres cosas con un sólo comando:
detail(solexa)y como buen objeto de R, podemos aplicar cualquiera de las funciones sobre solamente una parte:
sread(solexa[101:103])
  A DNAStringSet instance of length 3
    width seq
[1]    51 GGATCACGAGGTCAGGAGTTCAAGACCAGCCTGGCCAACATAGTGAAACCC
[2]    51 GCGAGATCTGCCCTCCAGCCAATTGAGGATCTTAATTAAGGGTCCTGACTC
[3]    51 TCTCCTTCAGTCAATGAAGTTGTATCTGTGGCTCCAAAGCACTTTTATAGT
Es de esperarse que conforme avancen los ciclos de secuenciación el resultado puede ir empeorando. De hecho, esta es una de las razones por la que no se pueden usar estos aparatos para obtener secuencias demasiado largas.
Podemos revisar la frecuencia de nucleótidos conforme avanza la secuencia. Desviaciones grandes podrían implicar un problema técnico, o se pueden deber a alguna propiedad del protocolo que se utilizó para preparar el material a secuenciar.
abc = alphabetByCycle(sread(solexa), alphabet=c("A","T","G","C","N"))
abc
        cycle
alphabet   [,1]   [,2]   [,3]   [,4]   [,5]   [,6]   [,7]   [,8]   [,9]  [,10]
       A 112448 192944 216755 273103 269983 284526 118650 161188 160457 297245
       T 116870 245013 184450 140492 155909 155166 333883 206429 226618 164910
       G 276721 218869 240398 243542 229062 182832 155879 191230 185372 195429
       C 314483 163696 178919 163385 165568 197998 212110 261675 248075 162938
       N      0      0      0      0      0      0      0      0      0      0
Para convertirlo a frecuencias podemos dividir por el número de secuencias:
abcFreq = abc / length(solexa)
abcFreq
        cycle
alphabet      [,1]      [,2]      [,3]      [,4]      [,5]      [,6]      [,7]
       A 0.1370445 0.2351479 0.2641672 0.3328406 0.3290381 0.3467622 0.1446031
       T 0.1424337 0.2986063 0.2247959 0.1712227 0.1900120 0.1891064 0.4069154
       G 0.3372499 0.2667436 0.2929818 0.2968135 0.2791662 0.2228240 0.1899754
       C 0.3832719 0.1995023 0.2180551 0.1991232 0.2017837 0.2413074 0.2585062
       N 0.0000000 0.0000000 0.0000000 0.0000000 0.0000000 0.0000000 0.0000000
Pero es mucho más fácil analizar esto en una figura:
Primero definamos una serie de colores, uno para cada base (y uno extra para las N). También necesitamos saber los ciclos que vamos a analizar, para usar como etiquetas.
cols = rainbow(5)

cycles = 1:max(width(solexa))
Ahora podemos producir una figura con la frecuencia de las bases.
barplot(abcFreq, ylim=c(0,1.1), col=cols, beside=FALSE, space=0, names.arg=cycles, las=3,
     xlab="cycle", ylab="Frequency", main="Base frequency by Cycle")

legend("top",legend=rownames(abcFreq), fill=cols, bty="n", horiz=TRUE)
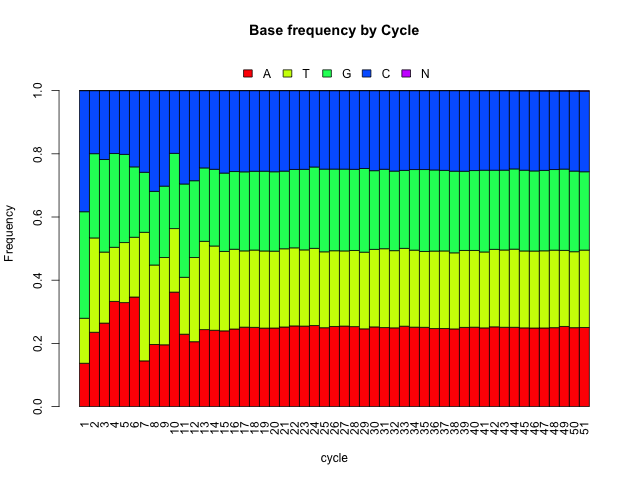
Notan las fluctuaciones en la composición durante los primeros ciclos? Esto es un problema técnico conocido, debido a que se usan hexámeros aleatorios durante la construcción de las bibliotecas. Ha sido discutido en el siguiente artículo:
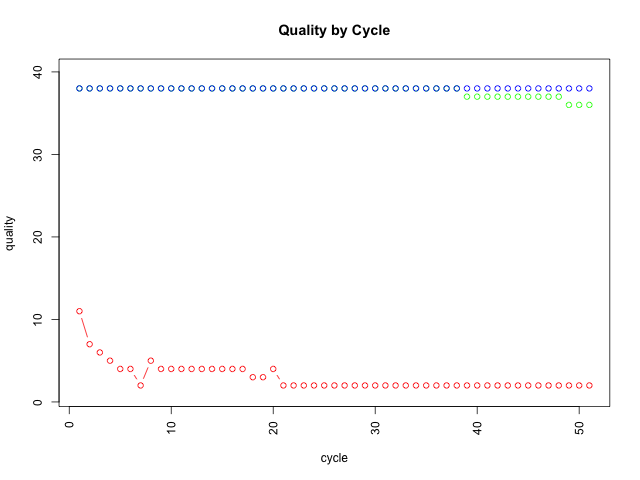
Por otro lado, la calificación de calidad de cada base también nos habla de la confianza con la que podemos tener en la identidad de esa base en particular. La calidad puede disminuir conforme avanzan los ciclos, pero debemos revisar que no baje demasiado.
Para convertir rápidamente las calidades codificadas a su valor numérico, podemos aprovechar que R internamente puede convertir los caracteres a valores numéricos:
as(quality(solexa[1]), "numeric")
[1] 34 34 31 31 26 34 34 30 30 30 29 26 31 29 29 33 20 29 32 30 20 34 34 25 34 30 31 ...
[39] 28 32 34 32 28 32 12 29 31 29 28 25 24
Si queremos convertir las calificaciones de calidad de todas las secuencias a la vez, manteniendo las que vienen de secuencias diferentes como series de números diferentes, podemos convertir directamente a una matriz:
numQuals = as(quality(solexa), "matrix")

head(numQuals)
     [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9] [,10] [,11] [,12] [,13] [,14]
[1,]   34   34   31   31   26   34   34   30   30    30    29    26    31    29
[2,]   35   28   20   30   32   31   21   28   34    21    13    33    31    33
[3,]   36   35   25   35   30   35   28   25   33    35    35    20    33    35
...
Y una vez más, queremos visualizar estos valores, resumiéndolos de alguna manera. Por ejemplo, podemos calcular el máximo, mínimo y mediana de los valores de calidad en cada ciclo:
maxQ  = apply(numQuals,2,max)
minQ  = apply(numQuals,2,min)
medQ  = apply(numQuals,2,median)

maxQ
minQ
 [1] 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 38 ...

 [1] 11  7  6  5  4  4  2  5  4  4  4  4  4  4  4  4  4  3  3  4  2  2  2  2  2 ...
Ahora podemos hacer una figura:
plot(cycles, minQ, type="b", col="red", main="Quality by Cycle", las=3, ylim=c(1,40),
        xlab="cycle", ylab="quality")
lines(cycles, medQ, type="b", col="green")
lines(cycles, maxQ, type="b", col="blue")
Ejercicios:
En muchas aplicaciones, queremos quitar las lecturas que recurren muchas veces con una secuencia idéntica. Estos pueden aparecer por culpa de la amplificación durante la construcción de la biblioteca. Esto es particularmente importante para experimentos de tipo RNA-Seq y ChIP-Seq.
Para quitar todos excepto la primera copia de las lecturas duplicadas, podemos hacer esto:
solexaUnique = solexa[!srduplicated(solexa)]

solexaUnique
class: ShortReadQ
length: 485526 reads; width: 51 cycles
Otra cosa que conviene revisar, es si tenemos muchas lecturas compuestas principalmente por una base. Es poco probable que estas vayan a ser de utilidad, y pueden surgir por problemas técnicos del secuenciador, o por la clonación de fragmentos de colas poliadeniladas.
Una manera de visualizar las secuencias para averiguar si tenemos este problema, es ordenarlas alfabéticamente:
srsort(sread(solexaUnique))
  A DNAStringSet instance of length 485526
         width seq
     [1]    51 AAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAA
     [2]    51 AAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAC
     [3]    51 AAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAG
     ...   ... ...
[485524]    51 TTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTCCAAA
[485525]    51 TTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTCT
[485526]    51 TTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTTT
Tenemos una serie de funciones para filtrar secuencias indeseadas. Podemos configurar un filtro para quedarnos solamente con lecturas que no tengan más de 40 bases idénticas. Tambien podemos generar un filtro para que pasen solo lecturas con a lo mucho 2 bases ambiguas, N:
pfilt = polynFilter(threshold=40)

nfilt = nFilter(threshold=2)
Ahora tenemos que aplicar estos filtros para quedarnos solamente con las lecturas que satisfacen las restricciones:
solexaUnique = solexaUnique[pfilt(solexaUnique)]

length(solexaUnique)

solexaUnique = solexaUnique[nfilt(solexaUnique)]

length(solexaUnique)
[1] 485355

[1] 484342
Finalmente, podemos guardar un nuevo archivo fastq con todas las lecturas buenas:
writeFastq(solexaUnique, "clean_reads.fq")
Ejercicios:
Los archivos que salen de una corrida completa de secuenciació pueden ser enormes y rápidamente nos podemos quedar sin memoria si queremos procesarlos completos. Tenemos un par de funciones para facilitar la exploración de estos archivos, que describiremos a continuación.
En primer lugar, podemos extraer una muestra aleatoria de un archivo Fastq, sin necesidad de cargar el archivo completo a memoria:
sampler = FastqSampler(fastqFile, n=1000)

fqSample  = yield(sampler)

close(sampler)
Podemos tomar cuantas muestras independientes querramos, antes de cerrar la conexión. Luego podemos trabajar con estos objetos como hemos venido haciendo:
fqSample

sread(fqSample)
class: ShortReadQ
length: 1000 reads; width: 51 cycles

  A DNAStringSet instance of length 1000
       width seq
   [1]    51 CTATGTTCTACATTTTTTTATATTTCAGGTTGAACGTTGGCTACTACACTA
   [2]    51 AATAACCCCAGGAAGTACCTTCGCAGTGTAGGAGATGGAGAGACTGTGGAG
   [3]    51 GGCAGACTCTGTTCCCAGTCCCTACCCAACCCTGGCTTGATCCTTGTCAGT
   ...   ... ...
 [998]    51 GGGACACAGCCAAACCATATCATTCTGCCCCTGGCCCCTCCCAAATCTCAT
 [999]    51 TCCAGGTCATAGGAATAGCCCCGATCCATGACCCCATATGCATACACAGAG
[1000]    51 GTTCAATGTCCCCTATGGTGTGGGCAAAGCTGCGGTGAGGACCCAGTGGCA
En segundo lugar, podemos ir recorriendo el archivo completo, avanzando muestra por muestra, mediante la función fastqStreamer y operando sobre cada muestra dentro de un ciclo:
streamer = FastqStreamer(fastqFile, n=10000)

while (length({fqSample = yield(streamer)})) {
   # Hacer algo con la muestra
   print(fqSample)
}

close(streamer)
class: ShortReadQ
length: 10000 reads; width: 51 cycles
class: ShortReadQ
length: 10000 reads; width: 51 cycles
class: ShortReadQ
length: 10000 reads; width: 51 cycles
...
Ejercicio Final: