En esta sesión veremos un paquete de Biocondudctor dedicado a la manipulación de secuencias biológicas. Biostrings está diseñado para poder trabajar con cadenas de caracteres muy largos (secuencias de DNA o RNA) de una manera sencilla y rápida.
Pero antes, veremos una descripción breve de los comandos básicos de R para manipulación de textos.
Se necesita lo siguiente para realizar esta práctica
| R | Instalado |
| Bioconductor | Instalado |
| Biostrings (paquete de BioC) | Instalado |
Durante esta página web, secciones de ejemplo de código, que pueden copiar directamente serán mostrados así:
1+1
Los resultados o salidas, se indicarán así:
[1] 2
Recuerden que si tienen alguna duda sobre una función, siempre vale la pena revisar la ayuda:
?library
Iniciemos R y generemos una cadena de texto:
R
texto <- "Esta es una cadena de texto"
La longitud del texto (length nos da la longitud del vector)
nchar(texto)
[1] 27
Podemos hacer sustitución de caracteres:
gsub(" ","_",texto)
[1] "Esta_es_una_cadena_de_texto"
Extraer una parte del texto:
substr(texto,9,18)
[1] "una cadena"
Encontrar las posiciones de una expresión regular:
gregexpr("[aeiou]",texto)
[[1]]
 [1]  4  6  9 11 14 16 18 21 24 27
attr(,"match.length")
 [1] 1 1 1 1 1 1 1 1 1 1
Partir la cadena, por una expresión regular:
palabras <- strsplit(texto," +")
palabras
[[1]]
[1] "Esta"   "es"     "una"    "cadena" "de"     "texto"
y pegarla de nuevo, en otro orden...
paste(rev(palabras[[1]]),collapse=" ")
[1] "texto de cadena una es Esta"
Ejercicios:
Ahora si empecemos a ver que nos ofrece Biostrings. Carguemos el paquete:
library(Biostrings)
Biostrings define una nueva clase de objeto XString, el cual puede ser de tipo BString (cadenas genéricas), DNAString, RNAString o AAString. Veamos como trabajar con un DNAString.
dnaSeq <- DNAString("TTCAGATCTAGTTCGTGTGTGACTGATGATCTGTCACACGTTTTTCTGATCTTCTGACTAGTCGAT")
dnaSeq
  66-letter "DNAString" instance
seq: TTCAGATCTAGTTCGTGTGTGACTGATGATCTGTCACACGTTTTTCTGATCTTCTGACTAGTCGAT
Podemos accesar a parte de la secuencia utilizando [ ]:
dnaSeq[4]
dnaSeq[4:10]
  1-letter "DNAString" instance
seq: A

  7-letter "DNAString" instance
seq: AGATCTA
(aunque para secuencias muy grandes, el autor de Biostrings recomienda usar la función substr que se encuentra optimizada para estas operaciones)
Existen muchas funciones definidas (o re-definidas) para trabajar con objetos tipo Xstring:
length(dnaSeq)
reverseComplement(dnaSeq)
alphabetFrequency(dnaSeq)
[1] 66

 66-letter "DNAString" instance
seq: ATCGACTAGTCAGAAGATCAGAAAAACGTGTGACAGATCATCAGTCACACACGAACTAGATCTGAA

 A  C  G  T  M  R  W  S  Y  K  V  H  D  B  N  -  +
12 13 14 27  0  0  0  0  0  0  0  0  0  0  0  0  0
También podemos leer archivos fasta, directamente generando el objecto apropiado:
faFile  <- system.file("extdata", "someORF.fa", package="Biostrings")
dnaSeqs <- readDNAStringSet(faFile,"fasta")
dnaSeqs
  A DNAStringSet instance of length 7
    width seq                                               names
[1]  5573 ACTTGTAAATATATCTTTTATTT...CTTATCGACCTTATTGTTGATAT YAL001C TFC3 SGDI...
[2]  5825 TTCCAAGGCCGATGAATTCGACT...AGTAAATTTTTTTCTATTCTCTT YAL002W VPS8 SGDI...
[3]  2987 CTTCATGTCAGCCTGCACTTCTG...TGGTACTCATGTAGCTGCCTCAT YAL003W EFB1 SGDI...
[4]  3929 CACTCATATCGGGGGTCTTACTT...TGTCCCGAAACACGAAAAAGTAC YAL005C SSA1 SGDI...
[5]  2648 AGAGAAAGAGTTTCACTTCTTGA...ATATAATTTATGTGTGAACATAG YAL007C ERP2 SGDI...
[6]  2597 GTGTCCGGGCCTCGCAGGCGTTC...AAGTTTTGGCAGAATGTACTTTT YAL008W FUN14 SGD...
[7]  2780 CAAGATAATGTCAAAGTTAGTGG...GCTAAGGAAGAAAAAAAAATCAC YAL009W SPO7 SGDI...
Un DNAStringSet es simplement una colección de objetos DNAString. Algunas funciones básicas para manipularlas son:
length(dnaSeqs)
width(dnaSeqs) # equivalente a nchar(dnaSeqs)
names(dnaSeqs)
[1] 7

[1] 5573 5825 2987 3929 2648 2597 2780

[1] "YAL001C TFC3 SGDID:S0000001, Chr I from 152168-146596, reverse complement, Verified ORF"
[2] "YAL002W VPS8 SGDID:S0000002, Chr I from 142709-148533, Verified ORF"
[3] "YAL003W EFB1 SGDID:S0000003, Chr I from 141176-144162, Verified ORF"
[4] "YAL005C SSA1 SGDID:S0000004, Chr I from 142433-138505, reverse complement, Verified ORF"
[5] "YAL007C ERP2 SGDID:S0000005, Chr I from 139347-136700, reverse complement, Verified ORF"
[6] "YAL008W FUN14 SGDID:S0000006, Chr I from 135916-138512, Verified ORF"
[7] "YAL009W SPO7 SGDID:S0000007, Chr I from 134856-137635, Verified ORF"
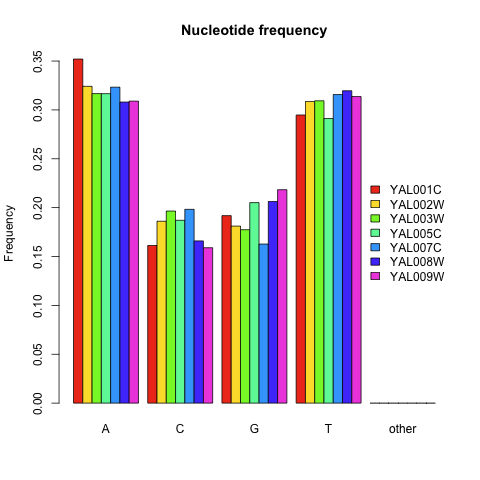
dinucleotideFrequency(dnaSeqs)
      AA  AC  AG  AT  CA  CC  CG  CT  GA  GC  GG  GT  TA  TC  TG  TT
[1,] 802 266 370 524 317 147 145 290 405 182 223 259 437 304 331 570
[2,] 688 320 325 555 362 225 147 350 382 184 221 268 456 355 362 624
[3,] 361 179 162 244 187 119  94 187 194 108  93 135 204 180 181 358
[4,] 488 209 255 292 247 146 115 226 283 129 170 224 226 250 266 402
...
narrow(dnaSeqs,1,100)
  A DNAStringSet instance of length 7
    width seq                                               names
[1]   100 ACTTGTAAATATATCTTTTATTT...CTCATGTAATAAAAGGTAACTAA YAL001C TFC3 SGDI...
[2]   100 TTCCAAGGCCGATGAATTCGACT...ATTTATTCGGTTCCGACGATGAA YAL002W VPS8 SGDI...
[3]   100 CTTCATGTCAGCCTGCACTTCTG...GATTCATAGCAGCTTGATTCTTA YAL003W EFB1 SGDI...
[4]   100 CACTCATATCGGGGGTCTTACTT...AAGTAATCATTATTAGTTAACTT YAL005C SSA1 SGDI...
[5]   100 AGAGAAAGAGTTTCACTTCTTGA...AAAAAAAATTATTCGGGGCGAGC YAL007C ERP2 SGDI...
[6]   100 GTGTCCGGGCCTCGCAGGCGTTC...AGCATCGATGATTTTCAGGAATT YAL008W FUN14 SGD...
[7]   100 CAAGATAATGTCAAAGTTAGTGG...GCTTAAACTTACTAACCCTAACC YAL009W SPO7 SGDI...
Y al final siempre podemos accesar a la secuencia como una cadena de texto normal:
as.character(dnaSeqs[[1]][1:50])
[1] "ACTTGTAAATATATCTTTTATTTTCCGAGAGGAAAAAGTTTCAAAAAAAA"
Ejercicios: