Bioconductor incluye el paquete limma (linear models for microarray analysis) que nos permite descubrir genes diferencialmente expresados en un conjunto de microarreglos. Es particularmente poderoso en casos donde no se cuenta con muchas réplicas biológicas, dando buenos resultados aún cuando solamente tenemos dos replicas. En términos generales, logra esto primero estimando la variabilidad global de todos los genes, la cual es una medida mucho más robusta que la variabilidad de los genes individuales. Después, comprime la variabilidad de cada gen hacia la variabilidad global, lo cual reduce mucho del ruido presente en los datos de microarreglos. Vamos a utilizar este paquete para encontrar genes que se encuentran significativamente diferencialmente expresados al comparar las muestras mutantes contra las mutantes (ver sesión anterior).
Lo primero que necesitamos tener es una tabla con valores de expresión ya normalizadas. En la práctica anterior ya produjimos una tabla así. Si no tienen el archivo, lo pueden bajar ahora: expr_normalizada.txt. Asegúrense de que lo guarden en el directorio de trabajo de R.
En una sesión de R, carguen los paquetes necesarios y lean el archivo:
library(Biobase)
library(limma)

# pueden usar list.files() para revisar que está el archivo en el lugar correcto
exprs = read.table("expr_normalizada.txt", header=TRUE, row.names=1)
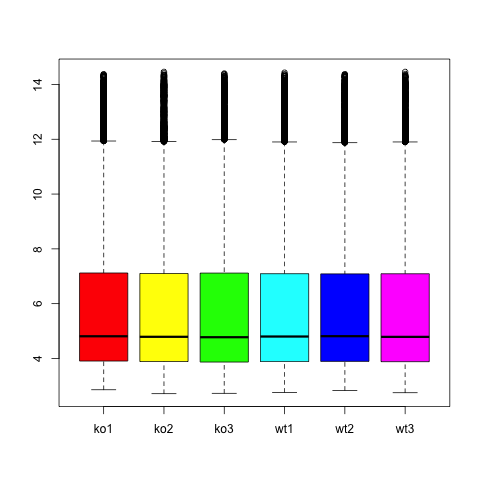
Siempre es una buena idea revisar el contenido de la tabla y asegurarnos que sí están normalizados los datos.
head(exprs)

boxplot(exprs, col=rainbow(6))
                   ko1       ko2       ko3       wt1       wt2       wt3
1415670_at    9.678634  9.710057  9.594718  9.721163  9.712254  9.687904
1415671_at    8.872975  8.865341  8.904089  8.854967  8.946216  8.966084
1415672_at   10.354395 10.318061 10.222677 10.469679 10.556538 10.436530
1415673_at   10.229100 10.318935  9.899033 10.052814  9.869369  9.974674
1415674_a_at 10.392037 10.401660 10.442584 10.352182 10.148918 10.321430
1415675_at    9.104457  8.972829  8.889293  8.975043  8.893407  8.997819
El siguiente paso es crear un par de matrices, describiendo las categorías de las muestras de nuestro experimento (diseño experimental) y las comparaciones que queremos hacer (contrastes). Vamos a crear un objeto design describiendo cuáles muestras son KO y cuáles son WT. El objecto contMatrix va a especificar que queremos comparar KO vs WT. Existen funciones que nos ayudan a construir estos dos objetos:
types = factor(c("KO","KO","KO","WT","WT","WT"))
types
[1] KO KO KO WT WT WT
Levels: KO WT
design = model.matrix(~ 0+types)
colnames(design) = levels(types)
design
  KO WT
1  1  0
2  1  0
3  1  0
4  0  1
5  0  1
6  0  1
contMatrix = makeContrasts(KO-WT, levels=design)
contMatrix
      Contrasts
Levels KO - WT
    KO       1
    WT      -1
Ahora ya podemos hacer los pasos del protocolo recomenado por limma, que consiste en ajustar modelos lineales a nuestros datos de expresión, estimar los contrastes deseados y comprimir las varianzas hacia un valor global. Para mayores detalles de estos procesos pueden accesar el manual de limma con limmaUsersGuide().
fit  = lmFit(exprs,design)
fit2 = contrasts.fit(fit,contMatrix)
fit2 = eBayes(fit2)
Ahora ya podemos pedir listas de genes diferencialmente expresados, en este caso queremos los mejores 20, ordenados por p-valor. También podríamos pedir la lista ordenada por logFC o por nivel de expresión (ver ?topTable).
topTable(fit2, number=20, sort.by="p")
En la lista debe aparecer 1428027_at, que es la sonda que corresponde al transcrito que ha sido eliminado en el KO.
| ID | logFC | AveExpr | t | P.Value | adj.P.Val |
| 1428027_at | -3.39 | 6.12 | -27.14 | 2.21e-09 | 0.000099 |
Nuestro resultado ya se está acercando a lo que queremos, pero aún no sabemos la identidad de los genes, puesto que sólo tenemos los identificadores de las sondas. Ahora procederemos a anotar esta lista, usando el paquete de anotación mouse4302.db.
Bioconductor incluye paquetes de anotación para muchos de los microarreglos más populares, además de información de anotación de los genes de muchos organismos modelo. La lista completa de paquetes de anotación disponibles en Bioconductor puede verse aquí.
Primero necesitamos cargar el paquete de anotación:
library(mouse4302.db)
Para ver todos los tipos de datos que incluye el paquete, hacemos:
mouse4302()
Como ejemplo, algunos de estos datos son:
| mouse4302PATH | contains 8871 probe ids mapped to KEGG pathways |
| mouse4302CHR | contains the chromosome for 41834 probe ids |
| mouse4302SYMBOL | has the Gene Symbol, or common name, for 41938 probe ids |
Para aprovechar esta información, necesitamos tener la lista de probe ids que nos interesan (o sencillamente todos los que tenemos en nuestro experimento). Entre otros lugares, esta lista está contenida en el objeto fit2 que creamos hace rato. Este objeto es bastante complejo, como podemos ver simplemente tecleando:
fit2
Si ven con cuidado, hay una sección $genes que contiene todos los probe ids. Para ver un poco del contenido de este elemento de fit2, tecleamos:
head(fit2$genes)
            ID
1   1415670_at
2   1415671_at
3   1415672_at
4   1415673_at
5 1415674_a_at
6   1415675_at
Con esto nos damos cuenta que para extraer todos los probe ids, podemos hacer:
probes = fit2$genes$ID
Ahora si podemos usar el paquete mouse4302.db para obtener todos los GENENAME (nombres descriptivos), SYMBOL (nombre corto o común) y ENTREZID (identificador único) para cada uno de los probe ids.
descriptions = mget(probes,mouse4302GENENAME)

symbols = mget(probes,mouse4302SYMBOL)

entrezids = mget(probes,mouse4302ENTREZID)
Finalmente, podemos agregar esta información de regreso a nuestro objeto fit2:
fit2$genes$EntrezID = unlist(entrezids)

fit2$genes$Symbol = unlist(symbols)

fit2$genes$Description = unlist(descriptions)
(Detalle técnico: la función unlist es necesaria para convertir las anotaciones a una columna de texto normal. En realidad aquí funciona bien debido a que nunca hay más de un ENTREZID, un SYMBOL y un GENENAME para un probe id. Para otro tipo de anotación, como categorías funcionales GO, donde un probe id puede tener más de un término GO, este proceso puede ser más complicado.)
Veamos si todo funcionó:
head(fit2$genes)
            ID EntrezID   Symbol                                       Description
1   1415670_at    54161     Copg           coatomer protein complex, subunit gamma
2   1415671_at    11972 Atp6v0d1  ATPase, H+ transporting, lysosomal V0 subunit D1
3   1415672_at    57437   Golga7          golgi autoantigen, golgin subfamily a, 7
4   1415673_at   100678     Psph                         phosphoserine phosphatase
5 1415674_a_at    60409  Trappc4            trafficking protein particle complex 4
6   1415675_at    13481     Dpm2 dolichol-phosphate (beta-D) mannosyltransferase 2
Veamos ahora como cambia el resultado de topTable, con la misma instrucción que usamos arriba:
topTable(fit2, number=20, sort.by="p")
Resulta mucho más fácil de interpretar, no?
Hay muchas maneras de visualizar estos resultados. Una manera común para datos de microarreglos es con un plot de volcán.
volcanoplot(fit2, highlight=10, names=fit2$genes$Symbol)
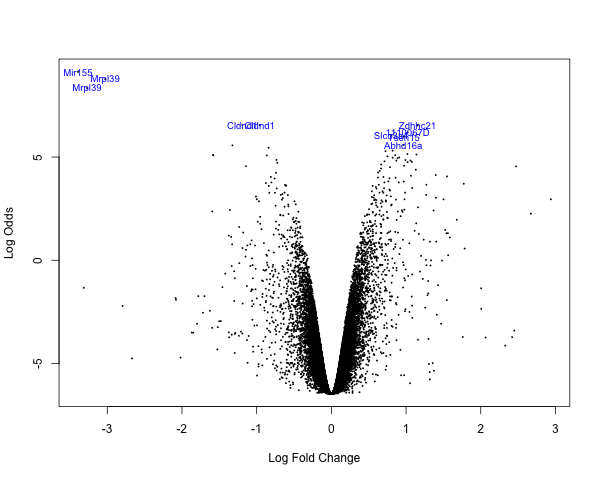
Este tipo de figura compara la magnitud de cambio (Log fold-change) en el eje de las X, con la significancia del cambio (en este caso Log Odds) en el eje de las Y. Podemos observar que hay una relación entre estos dos valores, pero no son equivalentes! Hay puntos con una gran magnitud de cambio, pero cuya significancia es muy baja y vice versa.
En este momento podemos generar una tabla anotada con todos las sondas que pasan los criterios que nosotros querramos, por ejemplo fold-change mayor a 1.5 y p-value por debajo de 0.05
deTable = topTable(fit2, number=nrow(fit2), lfc=log2(1.5), p.value=0.05)
dim(deTable)
También podemos obtener una tabla con todos los datos del microarreglo, ordenada por logFC en este caso:
fullTable = topTable(fit2, number=nrow(fit2), sort.by="logFC")
dim(fullTable)
Seguramente queremos guardar nuestros resultados con su anotación y valores estadísticos para la posteridad...
write.table(fullTable, file="full_results.txt", row.names=FALSE, sep="\t", quote=FALSE)