Antes de empezar a ver cómo usar BLAST, debemos tener claros algunos conceptos.
Homología es la relación evolutiva que existe entre dos secuencias (o caracteres, órganos, etc) cuando éstas tienen un ancestro en común. Por lo tanto, no tiene sentido hablar de un cierto nivel o porcentaje de homología. La realidad es que dos secuencias son o no son homólogas. Dos secuencias que se parecen sin tener un ancestro en común son análogas y pueden haber surgido por evolución convergente.
La homología se puede dividir en ortología y paralogía, dependiendo si la separación evolutiva entre dos secuencias ocurrió por un evento de especiación (ortólogos) o por un evento de duplicación (parálogos). Es más fácil de ilustrar con la siguiente figura (tomada de Walter Fitch, Trends in Genetics, 2000):
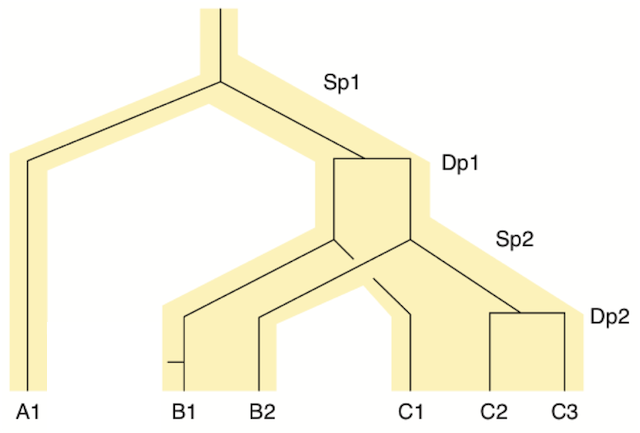
En la figura, podemos trazar la conexión entre B1 y B2, por ejemplo, y darnos cuenta de que son parálogos pues se separaron inicialmente por un evento de duplicación (Dp1). Del mismo modo podemos ver que A1 y B1 son ortólogos, pues se separaron por un evento de especiación (Sp1).
Una cuestión importante de todo esto, es que nos demos cuenta de que las relaciones evolutivas (aún para este caso relativamente sencillo) pueden ser muy complejas y a veces muy difíciles de descifrar si solamente tenemos secuencias actuales. Por ahora solamente vamos a aprender a realizar comparaciones de secuencias.
Cuando tenemos dos secuencias y no conocemos su historia evolutiva, puede no ser obvio si son homólogas o no. Una de las primeras cosas que hacemos, computacionalmente, es comparar las secuencias mediante un alineamiento. Esto puede ser ejemplificado con el siguiente esquema:
Prot1: HAKDHHSRRGLLKRV
       H KDHHSRRGLL++V
Prot2: HKKDHHSRRGLLRKV
El alineamiento consta de 15 aminoácidos alineados entre la secuencia Prot1 y Prot2. Cuando los aminoácidos alineados son idénticos, se indica con una letra concenso, cuando son residuos similares (K=Lys y R=Arg son ambos polares positivos) con una + y cuando ninguna de estas opciones, se deja un espacio en blanco. Por lo tanto, este alineamiento tiene una longitud de 15, un porcentaje de identidad del 80% (12/15) y un porcentaje de similitud del 93% (14/15).
Los porcentajes de similitud e identidad no son muy útiles así solos. La razón es porque nos interesa saber qué tan probable es que dicho alineamiento pudo haber ocurrido al azar. La idea es que si concluímos que pudo ocurrir al azar, diremos que las secuencias no son homólogas, mientras que si concluímos que es muy poco probable que haya ocurrido al azar, diremos que las secuencias sí son homólogas. Por ejemplo, es sencillo ver que un alineamiento con 100% de identidad, pero de solamente 3 residuos puede ocurrir muy fácilmente al azar. Del mismo modo, un alineamiento con "solo" 70% de identidad, pero a lo largo de 1,000 aminoácidos es muy poco probable que ocurra al azar, y muy probablemente se trataría de homología.
BLAST es una herramienta que busca alineamientos entre una secuencia y una base de datos que puede contener miles o millones de secuencias. Su velocidad ha sido optimizada, precisamente para permitir realizar búsquedas contra bases de datos muy grandes. Nos puede regresar el mejor alineamiento que encuentra entre dos secuencias, así como el porcentaje de similitud, de identidad y lo más importante: una medida estadística que nos permite decidir si el alineamiento pudo haber ocurrido por simple azar.
Para alcanzar su velocidad, no trata de calcular todos los alineamientos posibles entre dos secuencias, si no se concentra en regiones donde es probable que pueda ocurrir un buen alineamiento. Para esto, parte las secuencias que va a considerar en palabras cortas, de cierta longitud. Por ejemplo, si el tamaño de la palabra corta es 3, la secuencia HAKDHHSR quedaría representada de la siguiente forma:
HAKDHHSR
|
HAK
 |
 AKD
  |
  KDH
   |
   DHH
    |
    HHS
     |
     HSR
De este modo, BLAST puede concentrarse solamente en las regiones de las secuencias de la base de datos que comparten alguna de estas palabras cortas de 3 residuos con nuestra secuencia de interés. Una vez "anclado" el alineamiento con una de estas palabras, puede extenderse a ambos lados, buscando un alineamiento más largo. Existen matrices (o tablas) para poder calificar un alineamiento, donde los residuos idénticos reciben una calificación alta, los similares una más baja y los demás una calificación negativa. De este modo el alineamiento se puede ir extendiendo solo si incluye posiciones idénticas o similares, para que su calificación total vaya creciendo. Por ejemplo, si los residuos idénticos valen +3, los similares +1 y los diferentes -3, un alineamiento podría irse calificando así:
HAKDHHSR
  KDH     = 3 + 3 + 3 = 9
HKKDHHSR

HAKDHHSR
H KDHHSR  = 3 - 3 + 3 + 3 + 3 + 3 + 3 + 3 = 18
HKKDHHSR
BLAST luego usa modelos estadísticos para convertir esta calificación en un valor probabilístico, que toma en cuenta el tamaño de la secuencia y el de la base de datos contra la cual estamos realizando la búsqueda. El valor estadístico reportado es un E value, el cual puede interpretarse como el número de alineamientos con una calificación igual o mayor a la observada, que esperaríamos encontrar al azar, si todas las secuencias fueran aleatorias. Generalmente solo vamos a considerar alineamientos que tengan un E value muy bajo, por ejemplo menor que 0.001 o que 0.000001.
La explicación anterior, por razones de tiempo, ha tenido que ser una simplificación. Los interesados pueden revisar la página sobre BLAST en la Wikipedia, o revisar una página sobre la teoría estadística de las comparaciones de secuencias. Por ahora sigamos viendo como podemos usar BLAST.
Para los que quieran correr BLAST en sus computadoras, pueden bajarlo del siguiente sitio. Para los que tengan Windows, busquen el archivo ncbi-blast-#.#.##-win32/64.exe, los que tengan Mac OSX ncbi-blast-#.#.##.dmg y los que tengan Linux ncbi-blast-#.#.##...linux.tar.gz, donde si dice además ia32 es la versión de 32bits y si dice x64 es la versión de 64bits.
La documentación oficial del programa BLAST lo pueden encontrar en: http://www.ncbi.nlm.nih.gov/books/NBK52636/
Para poder usar BLAST, primero tenemos que tener una base de datos de secuencias contra la cual queremos hacer las búsquedas. Hay varias bases de datos ya creadas por NCBI que podríamos usar (ftp://ftp.ncbi.nih.gov/blast/db), sin embargo es bueno que aprendamos a crearlos por nuestra cuenta. La base de datos va a contener un registro de todas las palabras cortas (mencionadas en la sección anterior) en las que se pueden partir todas las secuencias que tengamos, así como la posición en la que ocurren para que puedan ser localizadas rápidamente.
Podemos generar una base de datos para BLAST a partir de cualquier conjunto de secuencias. Pueden descargar tres genomas en formato FASTA desde esta liga: 3genomas.tar.gz. Como habíamos visto en una de las clases sobre Linux, una de las maneras más convenientes es descargar el archivo directamente en la terminal. Pueden obtener la dirección del archivo al dar click con el botón derecho sobre la liga y eligiendo copiar liga. Usemos wget para descargarlo (dentro del Langebio, usen http://10.10.1.252):
wget "http://datos.langebio.cinvestav.mx/~cei/cursos/BioinfoBP/data/3genomas.tar.gz"
Cuando haya terminado la descarga, podemos descomprimirlo con la siguiente instrucción:
tar -zxvf 3genomas.tar.gz
Ahora deben tener tres archivos .faa para los genomas de A. thaliana, E. coli K12 y R. etli. Recuerden que pueden ver los archivos en el directorio actual usando el comando ls. Aprovechemos para recordar algunos otros comandos de Linux:
head -n 2 *.faa

grep -c ">" *.faa
==> A_thaliana.faa <==
>AT1G50920.1 | Symbols:  | Nucleolar GTP-binding protein | chr1:18870555-18872570 FORWARD LENGTH=671
MVQYNFKRITVVPNGKEFVDIILSRTQRQTPTVVHKGYKINRLRQFYMRKVKYTQTNFHAKLSAIIDEFPRLEQIHPFYGDLLHVLYNKDHYKLALGQVNTARNLISKISKDYVKLLKYGDS

==> E_coli_K12.faa <==
>NP_414542.1 thr operon leader peptide [Escherichia coli str. K-12 substr. MG1655]
MKRISTTITTTITITTGNGAG

==> R_etli.faa <==
>NP_660039.1 hypothetical protein RHE_PD00001 [Rhizobium etli CFN 42]
MAHCVTSPKIAVDEFSQCCGSAAANQPRRFRRCGWQQVVVPIASYPCGAIAHSRLAGTAGRLAICRAGANELMKGGCHFVRRLRSWSCSCATLGAFVLRSRSTVPLRGVIWLGSQTVTGTMP


A_thaliana.faa:27416
E_coli_K12.faa:4146
R_etli.faa:5963
Con ello podemos ver que efectivamente tenemos archivos con secuencias peptídicas, y que los tres archivos tienen mas o menos el número de secuencias que podemos esperar que los genomas codifiquen en su totalidad.
Ahora sí veamos cómo convertir estos archivos en bases de datos para realizar búsquedas con BLAST. El commando es makeblastdb y la manera en que lo vamos a usar es el siguiente:
makeblastdb -in E_coli_K12.faa -dbtype prot -parse_seqids -out E_coli_K12
Podemos ver la ayuda de este comando, para saber qué significan los diversos argumentos.
makeblastdb -help
 -in <File_In>
    Input file/database name

 -dbtype <String, `nucl', `prot'>
    Molecule type of target db

 -parse_seqids
    Option to parse seqid for FASTA input if set, for all other input types
    seqids are parsed automatically

 -out <String>
    Name of BLAST database to be created
    Default = input file name provided to -in argumentRequired if multiple
    file(s)/database(s) are provided as input
La opción menos obvia es -parse_seqids, pero es importante usarla para que la base de datos mantenga la información de los identificadores de las secuencias y no solamente las secuencias de aminoácidos.
Si creamos la base de datos correctamente, debemos tener varios archivos nuevos, iniciando con el texto especificado por la opción -n.
ls E_coli_K12.*
E_coli_K12.faa E_coli_K12.phr E_coli_K12.pin E_coli_K12.pog E_coli_K12.psd E_coli_K12.psi E_coli_K12.psq
En un momento veremos como utilizar esta base de datos, pero por ahora terminen el siguiente:
Ejercicio:
Ahora veamos cómo utilizar BLAST para encontrar secuencias homólogas a una proteína. Supongamos que tenemos la siguiente secuencia de una proteína que nos interesa:
>mi_proteina
MAQTTEKKKEIIEKFKTHETDTGSCEVQIALLTERILYLTEHFKTHAKDHHSRRGLLKLVGQRRNLLKYL
QKKDVTKYRTLIQQLGIRK
Copien y peguen esta secuencia a un archivo con gedit (o su editor favorito) y guárdenlo, por ejemplo con el nombre prot.faa
Para buscar secuencias parecidas a la nuestra, dentro de una base de datos, usamos instrucciones como esta:
blastp -db E_coli_K12 -query prot.faa
Antes de ejecutarlo, veamos la ayuda de blastp para entender las opciones que estamos usando, aunque probablemente sean bastante obvias:
blastp -help
 -db <String>
    BLAST database name

 -query <File_In>
    Input file name
Es importante indicar que hay diversas maneras en que BLAST puede hacer búsquedas, dependiendo del tipo de secuencia que tenemos y la base de datos. En las versiones actuales de ncbi-blast+ existen programas independientes para correr BLAST en cada modalidad. La siguiente tabla describe las opciones:
| Programa | Secuencia de interés | Base de datos |
|---|---|---|
| blastp | proteína | proteínas |
| blastn | nucleótidos | nucleótidos |
| blastx | nucleótidos (traducidos) | proteínas |
| tblastn | proteína | nucleótidos (traducidos) |
| tblastx | nucleótidos (traducidos) | nucleótidos (traducidos) |
Por ahora vamos a usar el programa blastp, pues tanto nuestra secuencia de interés como la base de datos contienen proteínas. Los programas que comparan secuencias de distinto tipo lo hacen traduciendo (en los 6 marcos de lectura) la(s) secuencia(s) nucleotídica(s) y luego comparando a nivel de proteínas.
Regresemos a nuestro ejemplo y veamos el resultado de ejecutar:
blastp -db E_coli_K12 -query prot.faa
Database: E_coli_K12.faa
           4,146 sequences; 1,312,978 total letters

Query= mi_proteina
Length=89
En esta sección podemos ver el resumen de la secuencia que buscamos (Query) y la base de datos donde la buscamos.
                                                                      Score     E
Sequences producing significant alignments:                          (Bits)  Value

NP_417634.1  30S ribosomal subunit protein S15 [Escherichia coli ...    101   9e-30
NP_415006.1  protein refolding molecular co-chaperone Hsp90, Hsp7...  25.8    0.52
Aquí podemos ver una lista de todas las secuencias en la base de datos que se parecen a nuestra secuencia. En particular hay que poner atención al E Value que refleja el número de secuencias que esperaríamos al azar, con el mismo o mejor Score, dado el tamaño de nuestra secuencia y la base de datos que usamos. Es decir, la segunda secuencia la encontramos probablemente por azar y no porque tenga una relación evolutiva con nuestra secuencia de interés.
>NP_417634.1 30S ribosomal subunit protein S15 [Escherichia coli str. K-12
substr. MG1655]
Length=89

 Score =   101 bits (252),  Expect = 9e-30, Method: Compositional matrix adjust.
 Identities = 48/89 (54%), Positives = 65/89 (73%), Gaps = 0/89 (0%)

Query  1   MAQTTEKKKEIIEKFKTHETDTGSCEVQIALLTERILYLTEHFKTHAKDHHSRRGLLKLV  60
           M+ +TE   +I+ +F     DTGS EVQ+ALLT +I +L  HF  H KDHHSRRGLL++V
Sbjct  1   MSLSTEATAKIVSEFGRDANDTGSTEVQVALLTAQINHLQGHFAEHKKDHHSRRGLLRMV  60

Query  61  GQRRNLLKYLQKKDVTKYRTLIQQLGIRK  89
            QRR LL YL++KDV +Y  LI++LG+R+
Sbjct  61  SQRRKLLDYLKRKDVARYTQLIERLGLRR  89
Esta sección muestra la descripción larga del alineamiento que BLAST encontró. Nos dice el porcentaje de identidad (54%) y de similitud (73%) y luego muestra un esquema del alineamiento. Al final BLAST nos muestra un resumen de los parámetros que fueron usados en la búsqueda, muchos de los cuales no especificamos por lo que no los discutiremos ahora.
Uno de los primeros parámetros que seguramente queremos cambiar, es el E Value que se usa como valor de corte. BLAST usa 10 por defecto, y en muchas casos queremos reducirlo para hacer una búsqueda más estricta:
blastp -db E_coli_K12 -query prot.faa -evalue 0.001
                                                                      Score     E
Sequences producing significant alignments:                          (Bits)  Value

NP_417634.1  30S ribosomal subunit protein S15 [Escherichia coli ...    101   9e-30
Como verán, ahora BLAST solo nos regresa el primer resultado.
Hay veces que el resultado completo, con el alineamiento y toda la información extra, puede ser de gran utilidad. Sin embargo, a veces simplemente queremos un resumen de las secuencias que fueron encontradas. Para ello podemos modificar la salida de la siguiente manera:
blastp -db E_coli_K12 -query prot.faa -evalue 0.001 -outfmt 7
# BLASTP 2.2.30+
# Query: mi_proteina
# Database: E_coli_K12
# Fields: query id, subject id, % identity, alignment length, mismatches, gap opens, q. start, q. end, s. start, s. end, evalue, bit score
# 1 hits found
mi_proteina NP_417634.1 53.93 89 41 0  1  89 1  89 9e-30   101
# BLAST processed 1 queries
Y podemos resumirla aún más, quitándo el encabezado:
blastp -db E_coli_K12 -query prot.faa -evalue 0.001 -outfmt 6
mi_proteina NP_417634.1 53.93 89 41 0 1 89 1 89 9e-30 101
Esta última manera nos permite manipular la salida más fácilmente. Por ejemplo, podemos encontrar los identificadores de la base de datos que BLAST encontró que se parecen a mi_proteina:
blastp -db E_coli_K12 -query prot.faa -evalue 0.001 -outfmt 6 | cut -f 2
NP_417634.1
Por último, BLAST tiene un programa para extraer secuencias de una de sus bases de datos, especificando el identificador que queremos:
blastdbcmd -db E_coli_K12 -entry NP_417634.1
>lcl|NP_417634.1 30S ribosomal subunit protein S15 [Escherichia coli str. K-12 substr. MG1655]
MSLSTEATAKIVSEFGRDANDTGSTEVQVALLTAQINHLQGHFAEHKKDHHSRRGLLRMVSQRRKLLDYLKRKDVARYTQ
LIERLGLRR
(recuérden que pueden usar comandos como wc, |, >, grep, sort, cut, uniq que vimos en las primeras clases)