Una de las ventajas de Linux, es que es igual de fácil (o difícil?) trabajar sobre muchos archivos que sobre uno solo. Es decir, los comandos que vimos en la práctica anterior pudimos haberlos empleado sobre un conjunto grande de archivos.
Al trabajar con múltiples archivos (por ejemplo, archivos FASTA con la secuencia de muchos genomas) es necesario entender el concepto del caracter comodín *. En donde pongamos este asterisco, el sistema lo va a interpretar como que ahí pueden ir cualquier tipo y cantidad de letras.
Para ilustrar esto obtengamos el resto de los archivos del genoma completo de Rhizobium etli. La vez pasada estuvimos trabajando con los datos del plásmido simbiótico. Ahora terminemos de bajar los archivos del resto de los replicones.
Para agilizar la descarga, pueden bajar este archivo que contiene a todos los demás: R_etli.tar.gz. Para los que quieran usar un comando de Linux para hacer esta (o cualquier otra) descarga, pueden usar wget. La dirección la pueden obtener dando click con el botón derecho y eligiendo copiar liga. Para los que estén trabajando sobre esta práctica desde fuera del Langebio, deben sustituir la dirección numérica con datos.langebio.cinvestav.mx
wget "http://10.10.1.252/~cei/cursos/BioinfoBP/data/R_etli.tar.gz"
--15:07:10--  http://10.10.1.252/~cei/cursos/BioinfoBP/data/R_etli.tar.gz
Connecting to 10.10.1.252:80... connected.
HTTP request sent, awaiting response... 200 OK
Length: 2169023 (2.1M) [application/x-gzip]
Saving to: `R_etli.tar.gz'

100%[=========================================================================================================>]
2,169,023   --.-K/s   in 0.02s

15:07:10 (103 MB/s) - `R_etli.tar.gz' saved [2169023/2169023]
El archivo que acaban de bajar está comprimido en un formato de Linux. La instrucción para descomprimirlo y obtener todos los archivos es:
tar -zxvf R_etli.tar.gz
R_etli/
R_etli/NC_004041.faa
R_etli/NC_004041.fna
R_etli/NC_004041.ptt
R_etli/NC_007761.faa
R_etli/NC_007761.fna
R_etli/NC_007761.ptt
R_etli/NC_007762.faa
R_etli/NC_007762.fna
R_etli/NC_007762.ptt
R_etli/NC_007763.faa
R_etli/NC_007763.fna
R_etli/NC_007763.ptt
R_etli/NC_007764.faa
R_etli/NC_007764.fna
R_etli/NC_007764.ptt
R_etli/NC_007765.faa
R_etli/NC_007765.fna
R_etli/NC_007765.ptt
R_etli/NC_007766.faa
R_etli/NC_007766.fna
R_etli/NC_007766.ptt
(-zxvf es igual que poner -z -x -v -f, donde la z es porque está comprimido con gzip, la x es para extraer, la v es para ver qué archivos va sacando y la f es para indicar que el archivo (file) que estamos especificando es el que queremos abrir)
Como se ve en la salida anterior, los archivos están dentro de una carpeta llamada
cd R_etli

ls
NC_004041.faa  NC_007761.faa  NC_007762.faa  NC_007763.faa  NC_007764.faa  NC_007765.faa  NC_007766.faa
NC_004041.fna  NC_007761.fna  NC_007762.fna  NC_007763.fna  NC_007764.fna  NC_007765.fna  NC_007766.fna
NC_004041.ptt  NC_007761.ptt  NC_007762.ptt  NC_007763.ptt  NC_007764.ptt  NC_007765.ptt  NC_007766.ptt
Pero qué pasa si queremos ver (o trabajar con) solamente los archivos de cierto tipo? Aquí es donde nos empieza a servir nuestro caracter comodín:
ls *.fna

ls *.ptt
NC_004041.fna  NC_007761.fna  NC_007762.fna  NC_007763.fna  NC_007764.fna  NC_007765.fna  NC_007766.fna

NC_004041.ptt  NC_007761.ptt  NC_007762.ptt  NC_007763.ptt  NC_007764.ptt  NC_007765.ptt  NC_007766.ptt
Ejercicios:
Después de los ejercicios anteriores, que tal si lo que quieren es obtener la secuencia de todos los factores sigma de R. etli. Para esto necesitamos tener archivos que contengan la secuencia (en este caso de aminoácidos) de todas las proteinas de este organismo. NCBI provee justo este tipo de archivos para sus genomas completos, y uds ya los deben tener junto con los demás que bajaron al principio de esta práctica. Son los que tienen extensión .faa (FASTA amino acid).
ls *.faa
NC_004041.faa NC_007761.faa NC_007762.faa NC_007763.faa NC_007764.faa NC_007765.faa NC_007766.faa
Con los comandos que vimos la sesión pasada, podemos explorar un poco el contenido de estos archivos:
head *.faa
==> NC_004041.faa <==
>gi|21492964|ref|NP_660039.1| hypothetical protein RHE_PD00001 [Rhizobium etli CFN 42]
MAHCVTSPKIAVDEFSQCCGSAAANQPRRFRRCGWQQVVVPIASYPCGAIAHSRLAGTAGRLAICRAGANELMKGGCHFVRRLRSWSCSCATLGAFVLRSRSTVPLRGVIWLGSQTVTGTMPATSRL
>gi|21492963|ref|NP_660038.1| insertion sequence transposase [Rhizobium etli CFN 42]
MMWARLPDQRFDLLSRVMHDHALIGGSKLRDVVETVRFCDTQTIELRERADRPARQATLCLRFGQATIRRPQNLREEGLPDGVRLSWVEVVEPDAPDGVEPLHWLLLTTHALSSATDAWQIVAWYKQRWMIEQFFRVMKTQGFKIEDSQLQLAPRLEKLVAIAAKAAAIVLQLVQDRSGGDPHPASLAVSPHEINTLAALESRFKGKTKLQSNPHPKASLAWAAWIVAKLGGWNGYASSKPPGPITFFNGLKYCADGWALRDRYMPQSFGGEMFHWIICFWSRTKSSDQRAEPSRWPGSVRACLQVRLRKGVSRAQHRR
>gi|21492961|ref|NP_660036.1| insertion sequence transposase [Rhizobium etli CFN 42]
MNIHKNARLTPLRREQMALAVIEGHLTQAQAAQAYGVAAKIVARWVERFKAGGREAMLDRSSRPHAMPRQTSQALAERIITLRRQRLTGKHIAIETGVSAATVSRVLKRAGLSRLKDIEPAEPVRRHERQAPGEMIHIDIKKLGRFHEVGHRITGDRTRQSSRRGKSWGAGWECVHVAIDDASRIAFSQISPDETKESAVAFLKAALAYYASLGIAVERVMTDNGPCYTSKPFGQACRDNGLKHVRTRPYTPKTNGKAERFIQTALREWAYAVAYPNSDMRAAELPRWLHRYNWHRPHGSLNSKPPITRLALTQDNLLRLHI

...
Muchas veces resulta práctico combinar muchos archivos en uno solo:
cat *.faa > R_etli.faa
Para asegurarnos que se generó correctamente el archivo, podemos volver a contar el número de secuencias que contiene:
grep -c ">" R_etli.faa
5956
Ahora si, ya habían encontrado todos los factores sigma en uno de los primeros ejercicios. Pero ahora lo que queremos hacer es conectar esta información con aquella de las secuencias de las proteinas. Como habrán visto al explorar los archivos .faa, se utiliza un identificador numérico llamado el gi (gene identifier). Este es idéntico a los valores que salen en la columna PID (protein identifier) de los archivos .ptt. Entonces, primero vamos a extraer estos valores para todas las proteinas que codifican para sigma factor:
grep "sigma factor" *.ptt | cut -f 4 > sigma_factor_gis.txt
Funcionó?
cat sigma_factor_gis.txt
86356086
86356395
86356760
86356962
86357406
86357980
86358383
86358552
86358667
86358721
86358872
86359102
86359512
86360282
86360568
86360790
86361152
86361192
Lo que ahora queremos hacer es encontrar cada uno de estos identificadores dentro del archivo que preparamos con las secuencias de todas las proteinas (R_etli.faa). De los comandos que hemos visto, cuál creen que nos pudiera servir? Qué tal grep? Pero tampoco queremos usar grep tantas veces a mano.
Linux cuenta con los manuales de todos sus comandos. Pueden ser muy extensos e intimidantes para los novatos, pero contienen muchísima información útil. Abramos entonces el manual de grep en busca de una opción para utilizar los patrones directamente del archivo sigma_factor_gis.txt:
man grep
GREP(1)

NAME
       grep, egrep, fgrep - print lines matching a pattern

SYNOPSIS
       grep [options] PATTERN [FILE...]
       grep [options] [-e PATTERN | -f FILE] [FILE...]

...
El manual puede ser bastante extenso. Generalmente conviene hacer una búsqueda de lo que queremos, en lugar de leerlo todo. Para ello podemos usar la tecla /, para buscar una palabra o frase. Desde dentro del manual, esto implicaría escribir:
/file
En este caso se menciona esa palabra en demasiados lugares. Pueden utilizar la barra espaciadora para avanzar de página en página. Muy pronto deben poder encontrar lo siguiente:
       -f FILE, --file=FILE
              Obtain patterns from FILE, one per line.  The empty file contains zero patterns, and therefore matches nothing.
Esto nos dice que podemos usar el parámetro -f para especificar un archivo con todos los patrones que queremos usar. Probémoslo:
grep -f sigma_factor_gis.txt R_etli.faa
>gi|86356086|ref|YP_467978.1| RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86356395|ref|YP_468287.1| RNA polymerase sigma factor protein (sigma-24) [Rhizobium etli CFN 42]
>gi|86356760|ref|YP_468652.1| ECF subfamily RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86356962|ref|YP_468854.1| RNA polymerase sigma factor protein (sigma-70) [Rhizobium etli CFN 42]
>gi|86357406|ref|YP_469298.1| transcriptional activator (anti-sigma factor) protein [Rhizobium etli CFN 42]
>gi|86357980|ref|YP_469872.1| RNA polymerase ECF-subfamily sigma factor [Rhizobium etli CFN 42]
>gi|86358383|ref|YP_470275.1| RNA polymerase sigma factor protein (sigma-24) [Rhizobium etli CFN 42]
>gi|86358552|ref|YP_470444.1| RNA polymerase sigma factor RpoD [Rhizobium etli CFN 42]
>gi|86358667|ref|YP_470559.1| RNA polymerase sigma factor protein (sigma-24) [Rhizobium etli CFN 42]
>gi|86358721|ref|YP_470613.1| RNA polymerase sigma factor protein (sigma-70) [Rhizobium etli CFN 42]
>gi|86358872|ref|YP_470764.1| RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86359102|ref|YP_470994.1| RNA polymerase ECF-subfamily sigma factor [Rhizobium etli CFN 42]
>gi|86359512|ref|YP_471404.1| ECF subfamily RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86360282|ref|YP_472170.1| RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86360568|ref|YP_472456.1| ECF subfamily RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86360790|ref|YP_472677.1| RNA polymerase ECF-subfamily sigma factor [Rhizobium etli CFN 42]
>gi|86361152|ref|YP_473039.1| RNA polymerase sigma factor [Rhizobium etli CFN 42]
>gi|86361192|ref|YP_473079.1| RNA polymerase sigma factor protein [Rhizobium etli CFN 42]
Pero no nos interesa meramente localizar los gis en los identificadores de las secuencias. Queremos además obtener las secuencias de cada uno de ellos. En este caso la secuencia se encuentra completa en el renglón que le sigue a cada identificador. Buscando en man grep podemos encontrar rápidamente /after:
       -A NUM, --after-context=NUM
              Print NUM lines of trailing context after matching lines.  Places a line containing -- between contiguous groups of matches.
Juntando estas dos opciones de grep podemos obtener lo que querímos:
grep -A 1 -f sigma_factor_gis.txt R_etli.faa
>gi|86356086|ref|YP_467978.1| RNA polymerase sigma factor [Rhizobium etli CFN 42]
MNDRTEAEEALQEVYISIWQRARSFQAASGSSSAWLSAIARNRSIDLLRARKPVADELDSAYDLADAAPDPERQAVTKDDGRRIDTCMEELEADRAVAVKRAYVEGLSYQELADQFGVPLNTMRTWLRRSLLKLRECMER
--
>gi|86356395|ref|YP_468287.1| RNA polymerase sigma factor protein (sigma-24) [Rhizobium etli CFN 42]
MEPERHVRMSVALTSFPAYSRARTESPVHPAVSKNAGSSEAAIASEADIRSGLTENLARLWRYGLVLSHQRDVADDLAQATCLRALERADQFVPGTRLDRWLFSILHSIWLNEIRSRRVREGQGFVDASEVLIFDGAHDTETHVMASQVLRRVSALPEAQRTAVFLAYVEGLSYREVAGILDIPIGTVMSRLASARARLSGDGTEGGRQ

...
Nota: casi todos los comandos de Linux tienen una ayuda resumida que se obtiene poniendo --help como argumento. Pudimos haber encontrado las dos opciones que acabamos de usar de grep haciendo:
grep --help
Ejercicio:
Evidentemente no queremos estar escribiendo todas las instrucciones una y otra vez, cuando nos interese estudiar proteinas de diversas funciones. Para poder automatizar el proceso, lo que hacemos es escribir un programa con las instrucciones deseadas y luego podemos correr este programa cuantas veces querramos.
Dado que los comandos de Linux contienen solamente texto, necesitamos un editor de texto para poder escribir un programa (ojo: Word no es un editor de texto). Hay muchos programas que podemos usar para editar texto. Vale la pena ahorita mencionar dos. El primero se llama nano y tiene la ventaja de que corre dentro de la misma terminal. El segundo se llama gedit y es un programa gráfico. Probemos como se ven ambos programas abriendo el archivo genes.faa producto del último ejercicio:
nano genes.faa
Podemos movernos con las flechas, agregar o borrar texto, usar los comandos que se muestran en el menú inferior como guardar los cambios (Ctrl-O), obtener ayuda (Ctrl-G) o salir del programa (Ctrl-X). Salgamos entonces de nano y veamos como funciona gedit:
gedit genes.faa
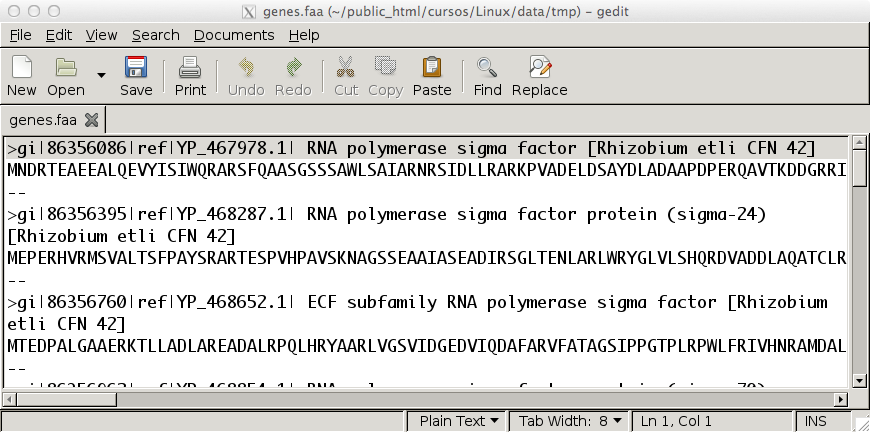
Con este programa seguro se sentirán más cómodos, pues tiene el típico menú y permite seleccionar cosas con el ratón, así como usar combinaciones como Ctrl-C para copiar y Ctrl-V para pegar.
Notas:
Ejercicio:
Para poder ejecutar o correr el programa que acabamos de escribir, podemos hacer:
sh get_genes.sh
Esto significa que queremos correr nuestro programa dentro de un nuevo shell. Piensen en el shell como lo que está corriendo dentro de la terminal que están usando, el cual recibe y procesa todas sus instrucciones.
Si al correr nuestro programa no se generó ningún error, probablemente funcionó bien. Hay que revisar el contenido del directorio donde lo corrimos y ver que existan los archivos que se tenían que generar y que tengan el contenido que deberían.
ls
R_etli.faa genes.faa genes.txt get_genes.sh
head genes.*
==> genes.faa <==
>gi|86356086|ref|YP_467978.1| RNA polymerase sigma factor [Rhizobium etli CFN 42]
MNDRTEAEEALQEVYISIWQRARSFQAASGSSSAWLSAIARNRSIDLLRARKPVADELDSAYDLADAAPDPERQAVTKDDGRRIDTCMEELEADRAVAVKRAYVEGLSYQELADQFGVPLNTMRTWLRRSLLKLRECMER
--

==> genes.txt <==
86356086
86356395
86356760
Si queremos correr de nuevo el programa, pero sobre otro genoma o buscando otro tipo de proteina, es tan sencillo como copiar el programa al lugar donde vive el otro genoma y/o editarlo para cambiar la palabra buscada en la descripción de los genes.
Ejercicio final:
| Comando | Significado | Ejemplos |
|---|---|---|
| wget | para cuando necesitamos bajar archivos del internet | wget "Dirección completa del archivo" |
| tar | combinar/comprimir una serie de archivos, y el proceso inverso | tar -zxvf archivo.tar.gz |
| * | caracter comodín, para referirnos a muchos archivos | ls *.faa grep "palabra" *.ptt |
| man | abrir el manual de un comando de Linux | man grep |
| grep | más opciones para este comando | grep -f arch_patrones archivo grep -A 1 patron archivo |
| --help | argumento para obtener ayuda rápida de cualquier comando | grep --help cat --help |
| nano | programa para editar texto dentro de la terminal | nano archivo |
| gedit | programa gráfico para editar texto | gedit archivo |
| sh | abrir un nuevo shell o correr un programa dentro de un shell | sh archivo.sh |